Stan na 5 października 2026 r. Ranking aktualizujemy co miesiąc. Każdy wynik pochodzi z oficjalnej tablicy testu albo z karty producenta i ma link w Źródłach. Wyniki podane przez producenta oznaczamy osobno, bo to deklaracja firmy, a nie niezależny pomiar. Nie mieszamy wersji testów: 60% w jednej wersji i 60% w drugiej to dwa różne wyniki.
W skrócie
- Najprostszy start dziś: darmowy czat w claude.ai albo chatgpt.com napisze pierwszy program bez instalowania czegokolwiek. Agenta, który pracuje na plikach na Twoim komputerze, najszybciej uruchomisz w aplikacji Claude w zakładce Code (od planu Pro), a za darmo w ograniczonym zakresie w aplikacji Codex albo w GitHub Copilot Free w VS Code. Jak zacząć krok po kroku.
- W niezależnym Terminal-Bench 4.0 prowadzą GPT-6 Astra z Codexem (58,2%) i Claude Fable 5.1 z Claude Code (57,9%). Trzeci jest Claude Opus 5 (53,9%).
- Anthropic deklaruje w tym samym teście 70,6% dla Claude Sonnet 5.5 i 66,4% dla Claude Opus 5.5. To wyniki producenta, które czekają na niezależne potwierdzenie.
- W WebDev Arena, gdzie o kolejności decydują głosy użytkowników, pierwszy jest Claude Opus 5.5, drugi GPT-6 Astra.
- Testy agentowe mierzą model razem z agentem, w którym pracuje. Ten sam model w innym narzędziu dostaje inny wynik.
- SWE-bench Verified i Aider Polyglot nie nadążają za premierami: ostatnie wpisy pochodzą z lutego 2026 r. i z października 2025 r.
- Dla zespołu ważniejsze od dwóch punktów w rankingu są warunki danych, uprawnienia agenta i koszt zadania. Najlepiej sprawdzić dwóch albo trzech kandydatów na własnym repozytorium.
Który model AI jest najlepszy do programowania w październiku 2026?
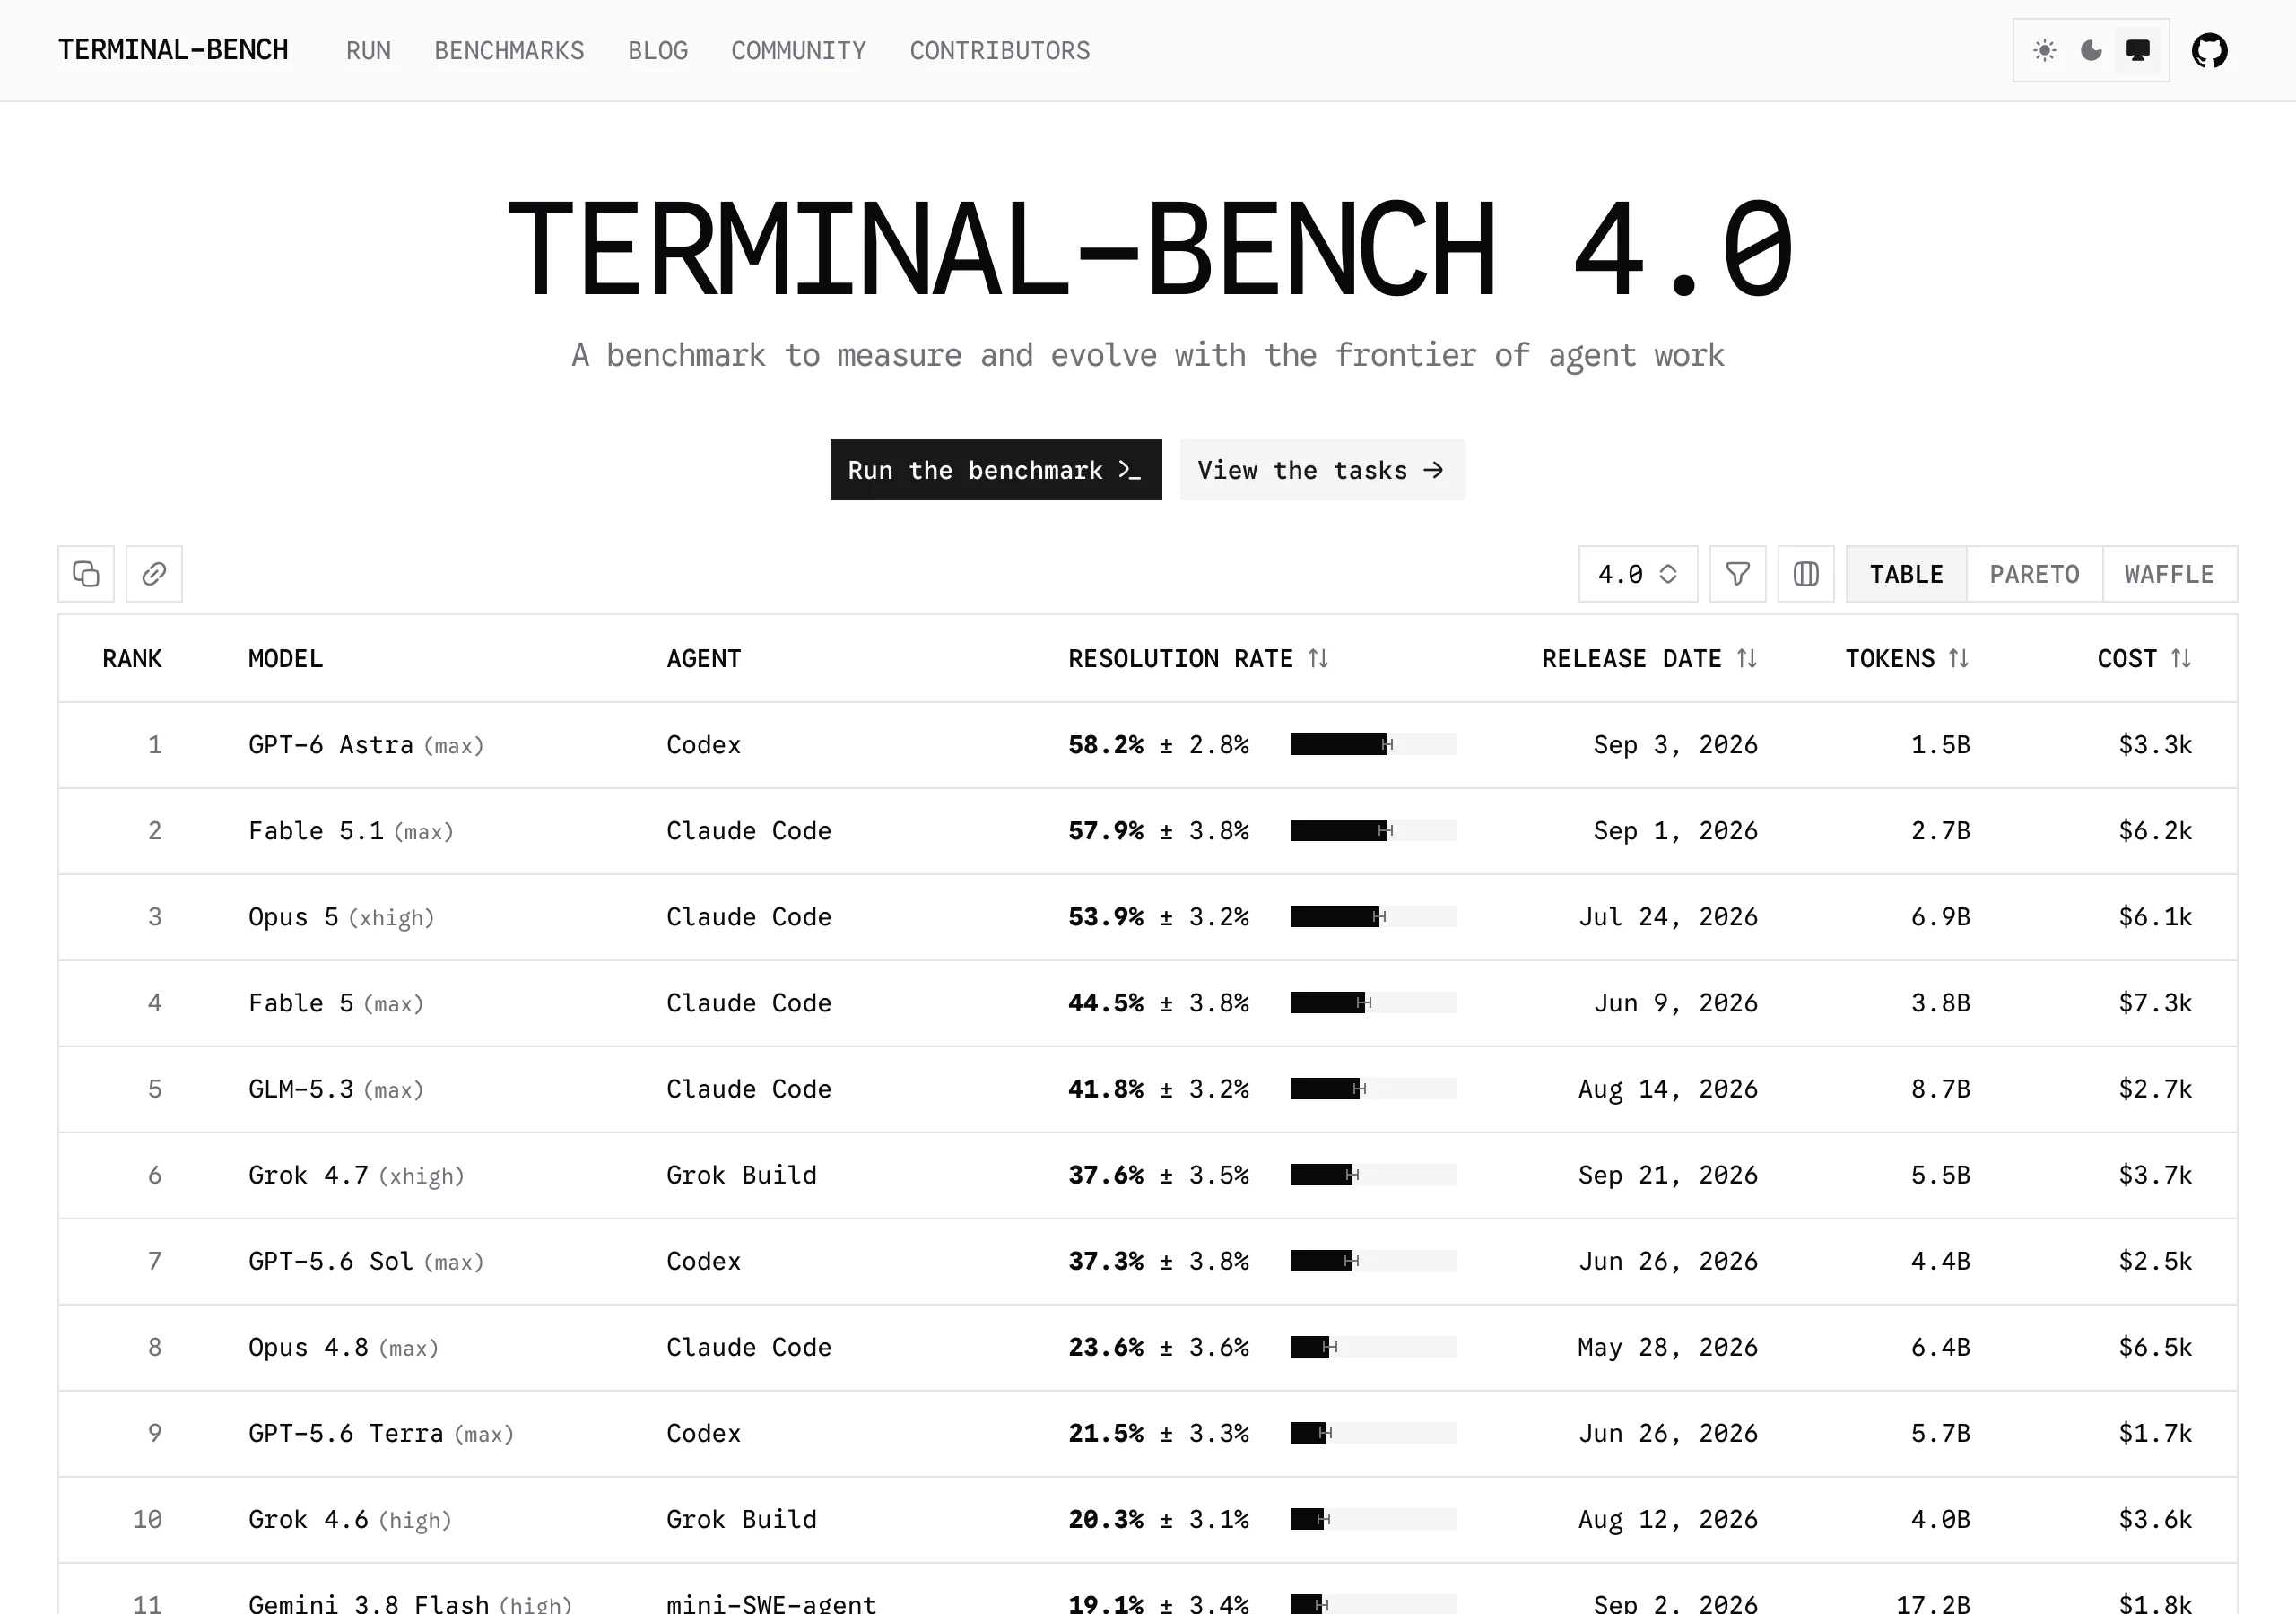
Według niezależnych pomiarów prowadzą dwie pary: GPT-6 Astra z agentem Codex i Claude Fable 5.1 z agentem Claude Code. Najświeższy niezależny test, Terminal-Bench 4.0, sprawdza, czy agent AI wykona w terminalu wieloetapowe zadanie inżynierskie, od konfiguracji systemu po naprawę programu, a wynik oceniają automatyczne testy. Test prowadzą Stanford, Harbor i Laude Institute, a tablicę ostatnio zaktualizowano 21 września 2026 r.
Tabela pokazuje pierwszych jedenaście modeli z tablicy, każdy z najlepszym wynikiem i agentem, w którym go uzyskał, w tej samej kolejności co na zrzucie niżej. Kolumna „wysiłek” to ustawienie effort, czyli to, jak długo model „myśli” przed odpowiedzią: wyższy poziom daje zwykle lepszy wynik, ale zużywa więcej czasu i tokenów, czyli jednostek tekstu, za które płaci się w API. Liczba po znaku ± to przedział błędu pomiaru.
| Model (producent) | Agent | Wynik w Terminal-Bench 4.0 | Wysiłek | Koszt całego przebiegu |
|---|---|---|---|---|
| GPT-6 Astra (OpenAI) | Codex | 58,2% ± 2,8 pkt | max | 3267 USD |
| Claude Fable 5.1 (Anthropic) | Claude Code | 57,9% ± 3,8 pkt | max | 6244 USD |
| Claude Opus 5 (Anthropic) | Claude Code | 53,9% ± 3,2 pkt | xhigh | 6086 USD |
| Claude Fable 5 (Anthropic) | Claude Code | 44,5% ± 3,8 pkt | max | 7265 USD |
| GLM-5.3 (Z.ai) | Claude Code | 41,8% ± 3,2 pkt | max | 2728 USD |
| Grok 4.7 (xAI, dziś pod marką SpaceXAI) | Grok Build | 37,6% ± 3,5 pkt | xhigh | 3683 USD |
| GPT-5.6 Sol (OpenAI) | Codex | 37,3% ± 3,8 pkt | max | 2542 USD |
| Claude Opus 4.8 (Anthropic) | Claude Code | 23,6% ± 3,6 pkt | max | 6481 USD |
| GPT-5.6 Terra (OpenAI) | Codex | 21,5% ± 3,3 pkt | max | 1734 USD |
| Grok 4.6 (xAI) | Grok Build | 20,3% ± 3,1 pkt | high | 3592 USD |
| Gemini 3.8 Flash (Google) | mini-SWE-agent | 19,1% ± 3,4 pkt | high | 1829 USD |
Pierwsze dwa miejsca to remis. Przedziały błędu obu par zachodzą na siebie, więc 0,3 punktu różnicy nic nie rozstrzyga. Koszt różni się już wyraźnie: przy tym samym wyniku 57,9% przebieg GPT-6 Astra na poziomie high kosztował 2269 USD, a Claude Fable 5.1 na poziomie xhigh 4872 USD, czyli ponad dwa razy więcej. Widać też, jak szybko starzeją się modele: Claude Opus 4.8 z końca maja 2026 r. rozwiązuje 23,6% zadań, czyli mniej niż połowę tego, co lider. Na tablicy brakuje najmocniejszych modeli Google: Gemini 3.8 Flash startował w prostym, badawczym agencie mini-SWE-agent, a Gemini 4 Argon jest na razie udostępniany tylko wybranym zespołom cyberbezpieczeństwa.
Czym różni się model AI od agenta, takiego jak Claude Code czy Codex?
Model to „mózg”, który pisze kod i podejmuje decyzje, na przykład Claude Opus 5.5 albo GPT-6 Astra. Agent, nazywany też szkieletem (ang. harness), to program, który daje modelowi ręce: czyta pliki, uruchamia polecenia i testy, pilnuje kontekstu i decyduje, kiedy skończyć. Claude Code, Codex, Gemini CLI i Grok Build to agenci budowani przez producentów modeli. Cursor i GitHub Copilot to narzędzia, w których model wybierasz z listy kilku producentów.
Testy agentowe, czyli SWE-bench i Terminal-Bench, mierzą zawsze parę: model plus szkielet. Agent decyduje, ile razy model może poprawić błąd, jakie ma narzędzia i ile kodu widzi naraz, więc ten sam model w innym agencie dostaje inny wynik. Dobrze to widać w tabeli wyżej: GLM-5.3 chińskiej firmy Z.ai wystartował w Claude Code, czyli w agencie Anthropic, a Gemini 3.8 Flash w minimalnym mini-SWE-agent. Te liczby mówią tyle samo o agencie, co o modelu.
Przy tym samym szkielecie wyniki są powtarzalne. Anthropic w ogłoszeniu Claude Opus 5.5 pisze, że publiczna tablica Terminal-Bench (5 prób na zadanie, agent Claude Code) podaje dla Claude Opus 5 wynik 51,8%, a własny pomiar firmy dał 52,3%, czyli w granicach szumu. xAI deklaruje dla Grok 4.7 37,6%, a tablica pokazuje dokładnie tyle samo. W praktyce oznacza to, że wybierając narzędzie dla zespołu, wybierasz od razu parę: Claude Code jest projektowany pod modele Anthropic, a Codex pod modele OpenAI. Kto chce zmieniać model co miesiąc, lepiej trafi w narzędzie wielomodelowe. Szerzej o samym agencie piszemy w artykule Claude Code: co to jest, ile kosztuje i jak zacząć.
Jak zacząć programować z AI już dziś?
Ranking pomaga wybrać narzędzie dla zespołu, ale żeby zacząć, nie musisz niczego wybierać na lata. Poniżej są trzy drogi od najprostszej: najpierw czat w przeglądarce, potem agent na plikach na Twoim komputerze, na końcu narzędzia dla programistów. Każda kolejna wymaga trochę więcej przygotowania i daje AI więcej możliwości.
Droga 1: darmowy czat w przeglądarce, bez instalowania
Wejdź na claude.ai albo chatgpt.com, załóż darmowe konto i opisz po polsku, czego potrzebujesz, na przykład „napisz w HTML prostą stronę, która liczy rabat od ceny”. Darmowy plan Claude tworzy artefakty, czyli gotową stronę albo program wyświetlany obok rozmowy, i potrafi uruchomić kod. To wystarczy na pierwszy skrypt albo prototyp. Ograniczenie jest jedno: czat nie widzi plików na Twoim dysku, więc kod przenosisz do projektu ręcznie.
Droga 2: agent, który pracuje na Twoich plikach
Tu AI samo czyta pliki w wybranym folderze, zmienia je i uruchamia polecenia. Najmniej kroków wymaga aplikacja Claude na komputer: pobierasz ją ze strony claude.com/download, logujesz się, klikasz zakładkę Code na górze okna, zostawiasz ustawienie Local i przyciskiem Select folder wskazujesz folder z projektem. Aplikacja ma Claude Code w środku, więc nie instalujesz osobno ani wersji terminalowej, ani Node.js. Zakładka Code wymaga płatnego planu, najtańszy jest Pro za 17 USD miesięcznie przy płatności rocznej albo 20 USD przy miesięcznej. Cały start ze zrzutami opisujemy w artykule Claude Code: co to jest i jak zacząć.
Jeśli nie chcesz od razu płacić, masz dwie darmowe opcje z ograniczeniami. OpenAI daje Codex w każdym planie ChatGPT, także darmowym, ale w planach Free i Go tylko w aplikacji na komputer, z modelem GPT-6 Luna, i zaznacza, że udostępnia to stopniowo. Codex w przeglądarce, w terminalu i w rozszerzeniu do edytora dostajesz dopiero od planu Plus za 20 USD miesięcznie. Druga opcja to GitHub Copilot Free w darmowym edytorze VS Code: najeżdżasz na ikonę Copilota na dolnym pasku, wybierasz Use AI Features i logujesz się, a bez subskrypcji GitHub zapisuje Cię do planu Free. Ten plan daje 2000 podpowiedzi kodu miesięcznie, pulę kredytów AI na czat i tryb agenta, ale model dobiera za Ciebie automat.
W praktyce: jeśli masz już płatny plan Claude albo ChatGPT, agenta do kodu masz w cenie. Zacznij od niego, zanim kupisz osobne narzędzie.
Droga 3: terminal i edytory kodu, dla programistów
Pełną kontrolę dają wersje terminalowe i rozszerzenia do edytorów: Claude Code w terminalu, w VS Code i w edytorach JetBrains, Codex CLI, Copilot CLI, który GitHub daje w każdym planie, także darmowym, oraz Cursor, czyli edytor z wbudowanym agentem i modelami kilku producentów. Te narzędzia podłączysz do skryptów, testów i automatycznego przeglądu kodu, ale wymagają instalacji i podstaw pracy w terminalu. Instalację Claude Code w terminalu krok po kroku pokazujemy w części Droga C: terminal i edytory kodu.
Jakie testy mierzą AI do programowania i których wariantów nie mieszać?
Każdy test mierzy co innego i jest aktualizowany w innym tempie. W tabeli widać, co sprawdza dany test, kto go prowadzi i jak świeży jest ostatni wpis na tablicy.
| Test | Co mierzy | Kto prowadzi | Ostatni wpis na tablicy (odczyt 2.10.2026) |
|---|---|---|---|
| SWE-bench Verified | Agent naprawia 500 zgłoszeń z prawdziwych repozytoriów open source, a wynik sprawdzają testy. | Zespół SWE-bench (swebench.com) | 26 lutego 2026 r. |
| SWE-bench Multilingual | To samo zadanie w repozytoriach w innych językach programowania. | Zespół SWE-bench (swebench.com) | 20 lutego 2026 r. |
| SWE-bench Pro (zestaw publiczny) | 731 trudniejszych zadań z repozytoriów na licencjach copyleft, takich jak GPL, które utrudniają włączenie kodu do danych treningowych; rozwiązanie zmienia średnio 107 linii w 4 plikach. | Scale AI | Brak daty na tablicy; najnowszy wpis, oznaczony jako NEW, to Muse Spark 1.1 firmy Meta. |
| Terminal-Bench 4.0 | Agent wykonuje w terminalu wieloetapowe zadania z inżynierii oprogramowania, konfiguracji systemu i analizy danych. | Stanford, Harbor i Laude Institute | 21 września 2026 r. |
| WebDev Arena | Użytkownicy w ciemno wybierają lepszą z dwóch aplikacji webowych zrobionych przez modele; z głosów powstaje ranking punktowy. | Arena (dawniej LMArena) | Ranking na bieżąco, modele z września 2026 r. już są. |
| Aider Polyglot | Model edytuje kod w 225 ćwiczeniach z serwisu Exercism w 6 językach. | Aider | 20 listopada 2025 r. (ostatnia aktualizacja strony) |
Wyników z różnych wariantów i wersji testu nie porównuj ze sobą. Scale AI pisze, że przy starcie SWE-bench Pro, gdy większość czołowych modeli miała ponad 70% w SWE-bench Verified, najlepsze w SWE-bench Pro dochodziły do 23%. Z Terminal-Bench jest tak samo: DeepSeek-V4.1-Flash ma w karcie modelu 90,6% w wersji 2.1 i 31,2% w wersji 4.0. Starsza wersja testu jest dla dzisiejszych modeli za łatwa i przestaje rozróżniać czołówkę.
Aider Polyglot, przez długi czas popularny test edycji kodu, nie był aktualizowany od 20 listopada 2025 r. Prowadzi tam GPT-5 na poziomie high z wynikiem 88,0%, a modeli z 2026 r. nie ma wcale, więc do wyboru narzędzia dziś się nie nadaje.
Co pokazują niezależne tablice SWE-bench?
Najuczciwsze porównanie samych modeli daje SWE-bench Verified w trybie bash only: każdy model dostaje tego samego minimalnego agenta mini-SWE-agent, który ma do dyspozycji tylko terminal. Różnica w wyniku wynika więc z modelu, a nie ze sprytu agenta. Kłopot w tym, że ostatnie wpisy pochodzą z lutego 2026 r. i nie ma tam żadnego modelu z ostatniego półrocza.
Tabela pokazuje czołówkę tej tablicy razem z kosztem rozwiązania jednego zadania.
| Model | Wynik | Test i wariant | Koszt na zadanie |
|---|---|---|---|
| Claude 4.5 Opus (wysiłek high) | 76,8% | SWE-bench Verified, bash only, mini-SWE-agent 2.0 | 0,75 USD |
| Gemini 3 Flash (high) | 75,8% | SWE-bench Verified, bash only, mini-SWE-agent 2.0 | 0,36 USD |
| MiniMax M2.5 (high) | 75,8% | SWE-bench Verified, bash only, mini-SWE-agent 2.0 | 0,07 USD |
| Claude 4.6 Opus | 75,6% | SWE-bench Verified, bash only, mini-SWE-agent 2.0 | 0,55 USD |
| GPT 5.2 (high) | 72,8% | SWE-bench Verified, bash only, mini-SWE-agent 2.0 | 0,47 USD |
| GLM 5 (high) | 72,8% | SWE-bench Verified, bash only, mini-SWE-agent 2.0 | 0,53 USD |
| Kimi K2.5 (high) | 70,8% | SWE-bench Verified, bash only, mini-SWE-agent 2.0 | 0,15 USD |
| DeepSeek V3.2 (high) | 70,0% | SWE-bench Verified, bash only, mini-SWE-agent 2.0 | 0,45 USD |
Dziś ta tabela uczy głównie o koszcie. MiniMax M2.5, model z otwartymi wagami, czyli do pobrania i uruchomienia na własnych serwerach, rozwiązał prawie tyle samo zadań co Claude 4.5 Opus za mniej więcej jedną dziesiątą ceny. Czołówka tej tablicy mieści się między 70% a 77%, więc Verified przestał wyraźnie rozróżniać najlepszych. Wyższe wyniki w głównej tablicy Verified, do 79,2%, należą do systemów agentowych firm, które same zgłosiły wynik; zespół SWE-bench oznacza je jako niezweryfikowane.
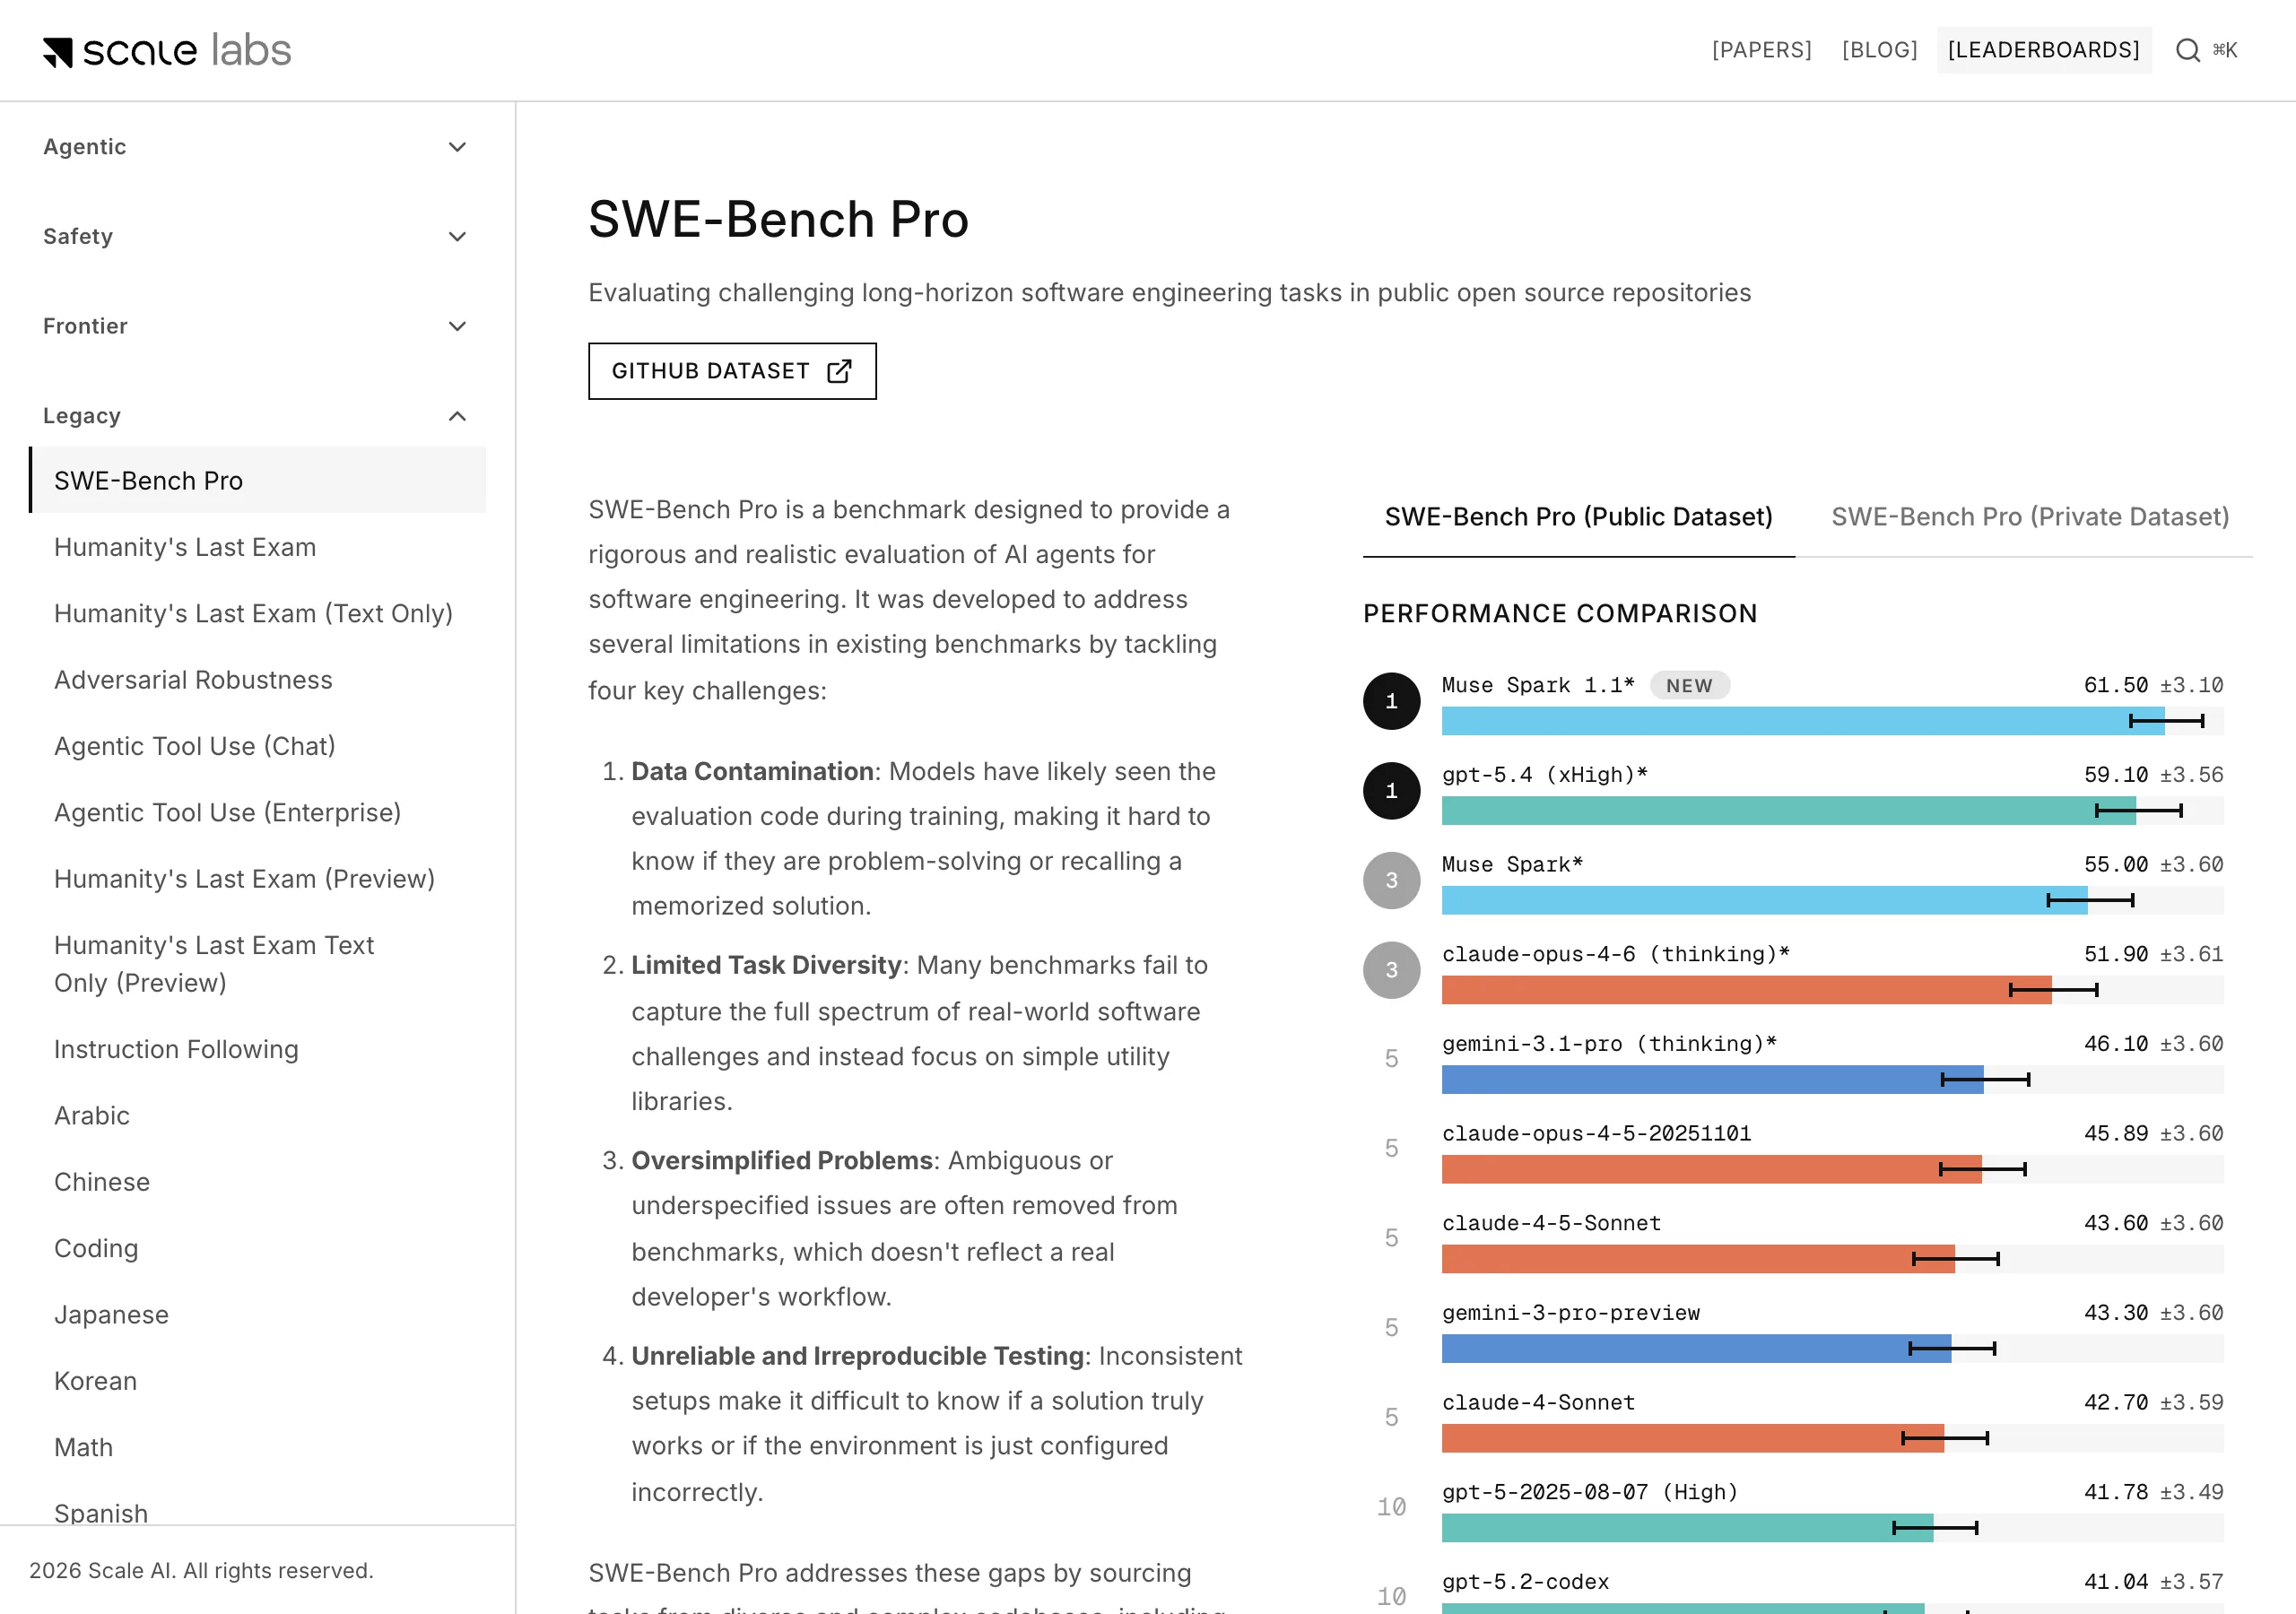
Na publicznej tablicy SWE-bench Pro pierwsze miejsce dzielą Muse Spark 1.1 firmy Meta (61,5%) i GPT-5.4 na poziomie xHigh (59,1%). Ich przedziały błędu, ±3,1 i ±3,6 punktu, zachodzą na siebie i na tablicy oba modele mają numer 1. Tak samo trzecie miejsce dzielą Muse Spark (55,0%) i Claude Opus 4.6 (51,9%). Tu też brakuje modeli z ostatnich miesięcy, a wszystkie cztery czołowe wyniki uzyskano w agencie mini-SWE-agent zamiast standardowego SWE-agent, co Scale oznacza gwiazdką.
Co deklarują producenci najnowszych modeli?
Modele z września 2026 r. są nowsze niż większość niezależnych tablic, więc o nich wiemy na razie tyle, ile napisali producenci. Bierzemy wyniki z testów z naszej listy. Gdy producent żadnego z nich nie podał, pokazujemy jego jedyny wynik w kodowaniu i zaznaczamy, że to test spoza listy.
| Model (producent) | Wynik producenta | Test i wariant | Uwagi |
|---|---|---|---|
| Claude Sonnet 5.5 (Anthropic, 28.09.2026) | 70,6% | Terminal-Bench 4.0 | Niezależnej tablicy jeszcze nie ma. Cena: 2 USD za milion tokenów wejściowych, 10 USD za milion wyjściowych. |
| Claude Opus 5.5 (Anthropic, 22.09.2026) | 66,4% | Terminal-Bench 4.0, wysiłek xhigh | Anthropic podaje błąd ±2,6 pkt. Cena: 4 USD i 20 USD za milion tokenów. |
| GPT-6 Astra (OpenAI) | 57,9% | Terminal-Bench 4.0, wysiłek high | Niezależna tablica pokazuje 57,9% (high) i 58,2% (max), czyli to samo. |
| Grok 4.7 (xAI, 21.09.2026) | 37,6% | Terminal-Bench 4.0 | Niezależna tablica: 37,6%. Cena: 2 USD i 6 USD za milion tokenów. |
| DeepSeek-V4.1-Flash (DeepSeek) | 31,2% | Terminal-Bench 4.0 (w wersji 2.1: 90,6%) | Otwarte wagi na licencji MIT. |
| Kimi K3 (Moonshot AI) | 88,3% | Terminal-Bench 2.1, własny agent Kimi Code | Karta modelu nie podaje wyniku w wersji 4.0, więc nie porównuj tej liczby z wierszami wyżej. |
| Mistral Medium 3.5 (Mistral AI) | 77,6% | SWE-bench Verified | Karta nie opisuje agenta, w którym zmierzono wynik. |
| Gemini 4 Argon (Google) | 77,9% | DeepSWE v1.1 (test spoza naszej listy) | Google nie podał wyniku w żadnym teście z listy; model trafia na razie do wybranych zespołów cyberbezpieczeństwa. |
Tam, gdzie da się to sprawdzić, deklaracje producentów zgadzają się z niezależną tablicą co do punktu procentowego (GPT-6 Astra, Grok 4.7). Wyniki Opus 5.5 i Sonnet 5.5 są więc wiarygodne, ale nadal czekają na potwierdzenie. Tańszy Sonnet 5.5 wypada w Terminal-Bench 4.0 lepiej od Opus 5.5, a w teście CursorBench 4.0 Anthropic podaje odwrotną kolejność: 55,5% wobec 57,8%.
Widać też zmianę zwyczajów. W kartach Anthropic, OpenAI, xAI i DeepSeek z września 2026 r. nie ma wyniku SWE-bench Verified. Zamiast niego pojawiają się nowsze testy, takie jak DeepSWE, FrontierCode czy CursorBench, których nie prowadzi żadna wspólna, niezależna tablica.
Chcecie sprawdzić agentów na własnych zadaniach, a nie na cudzych testach?
Na warsztacie „Agenci AI” budujemy w Claude Code agenta na procesach Waszej firmy i podłączamy go do narzędzi, których już używacie. Bez programowania, 1 albo 2 dni, stacjonarnie lub online, w grupie do 15 osób.
Claude Code czy Codex: co wybrać?
W jakości to dziś remis, a różnice leżą w koszcie i ekosystemie. W Terminal-Bench 4.0 najlepsza para z Codexem (GPT-6 Astra) i najlepsza para z Claude Code (Claude Fable 5.1) dzielą 0,3 punktu, a przebieg z Codexem kosztował przy tym samym wyniku mniej. Anthropic odpowiada, że nowy Opus 5.5 na domyślnym poziomie wysiłku dorównuje GPT-6 Astra za około 40% kosztu. To jednak wynik producenta, którego niezależna tablica jeszcze nie sprawdziła.
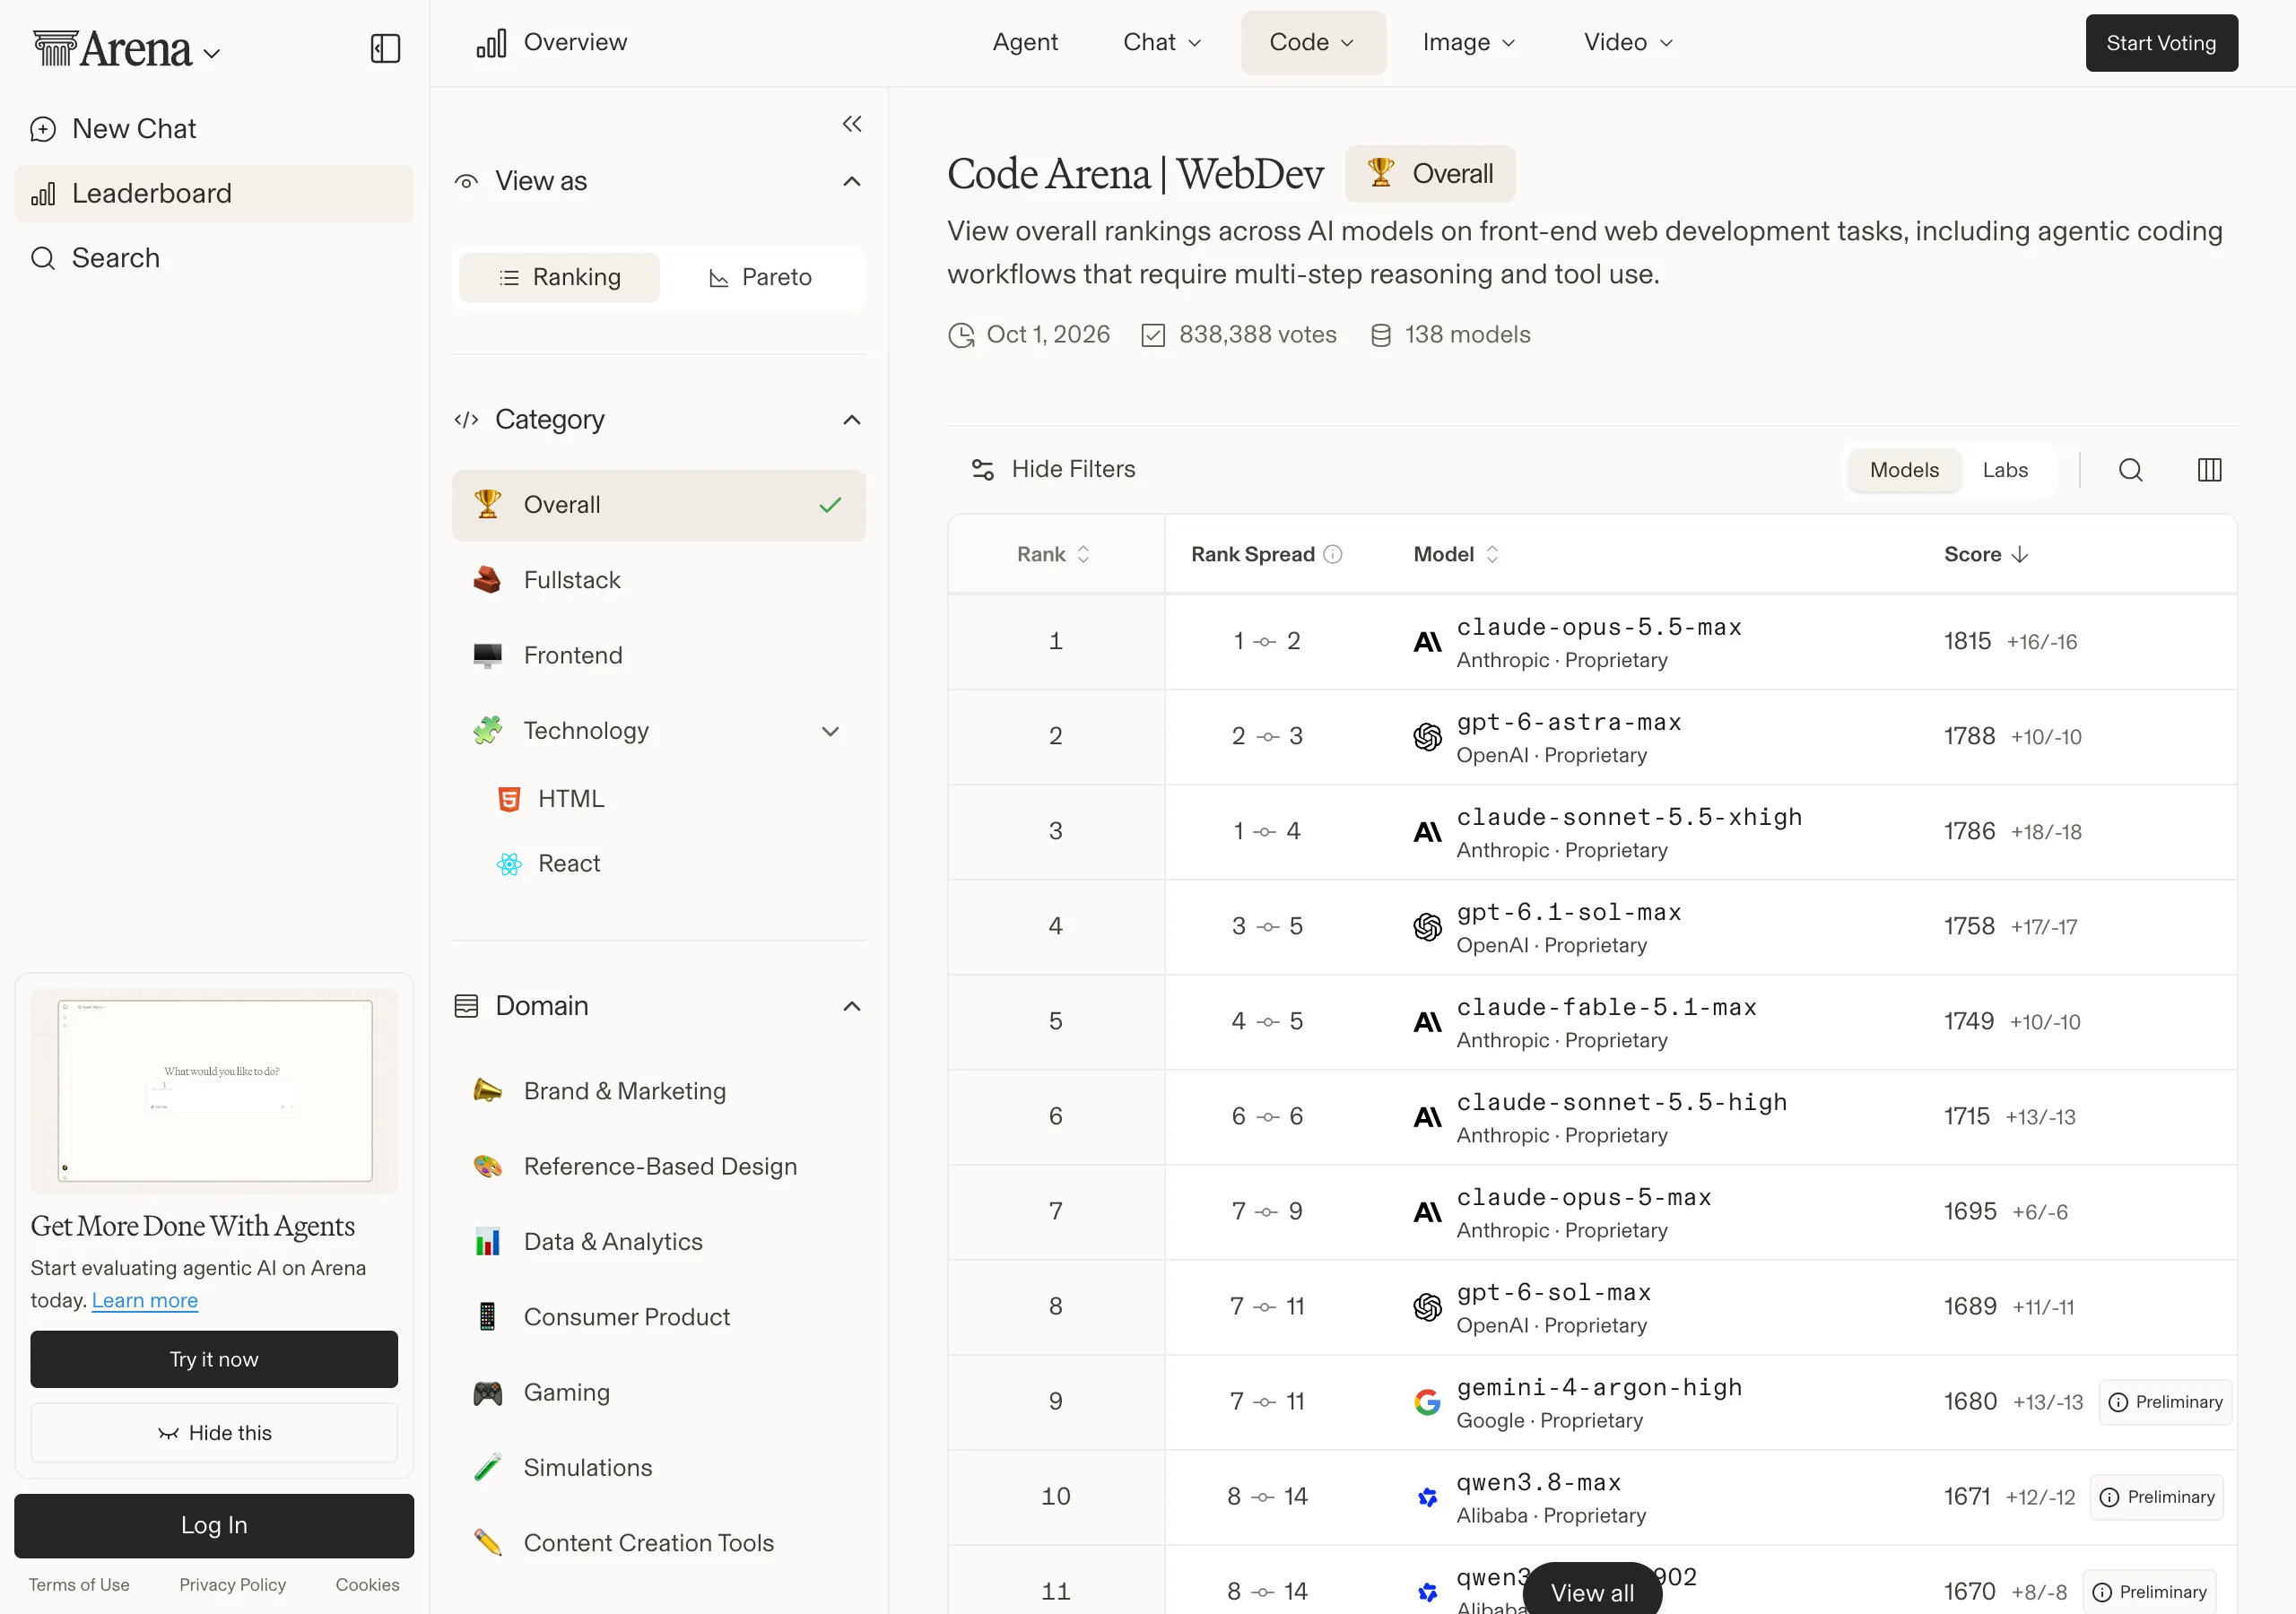
W WebDev Arena na prowadzeniu jest Claude Opus 5.5 z wynikiem 1815 punktów, przed GPT-6 Astra (1788) i Claude Sonnet 5.5 (1786). Arena podaje przy każdym modelu zakres miejsc, które mieszczą się w błędzie: dla Opus 5.5 to miejsca 1–2, dla Sonnet 5.5 miejsca 1–4. Ranking zaktualizowano 1 października 2026 r. i stoi za nim 838 388 głosów oddanych na 138 modeli. Mierzy on, co ludziom bardziej się podoba w zadaniach front-endowych, czyli przy budowie interfejsu stron i aplikacji, a nie poprawność kodu w dużym repozytorium.
Przy wyborze między Claude Code a Codexem rozstrzygają więc pytania praktyczne. Na jakim planie firmowym już jesteście, Claude Team i Enterprise czy ChatGPT Business i Enterprise? Gdzie pracuje zespół: w terminalu, w edytorze kodu, w przeglądarce? I czy potrzebujecie swobody w wyborze modelu? Jeśli tak, GitHub Copilot ma modele OpenAI, Anthropic, Google, xAI i Moonshot AI, a Cursor obsługuje między innymi modele OpenAI, Anthropic, Google i xAI. Kto woli otwarte narzędzie, ma Gemini CLI od Google, udostępnione na licencji Apache 2.0.
Jak wybrać AI do programowania dla zespołu?
Ranking pokazuje, kto wygrywa na cudzych zadaniach. Dla firmy liczą się jeszcze cztery rzeczy, których żadna tablica nie mierzy.
Gdzie trafia Wasz kod?
Kod musi trafiać do modelu na warunkach komercyjnych. Anthropic nie trenuje modeli na danych z kont Team, Enterprise i API, chyba że firma sama się na to zgodzi. OpenAI domyślnie nie trenuje na danych z ChatGPT Business, Enterprise i z API. Na prywatnych kontach pracowników decydują ustawienia, których w firmie nikt nie sprawdza, więc pierwszym krokiem jest plan firmowy.
Co agent może zrobić bez pytania?
Agent działa z uprawnieniami użytkownika: zmienia pliki, uruchamia programy, łączy się z internetem. Tryb uprawnień, czyli zasady, co agent robi sam, a o co pyta, ustawcie centralnie dla całej firmy.
Osobne ryzyko to prompt injection, czyli ukryte polecenia w treści, którą agent czyta: w zgłoszeniu, w zależności z internetu, w pliku od klienta. Anthropic pisze w dokumentacji Claude Code, że żaden system nie jest na takie ataki całkowicie odporny. Kod od agenta przechodzi więc ten sam code review, czyli przegląd przez drugiego programistę, co kod człowieka.
Ile naprawdę kosztuje jedno zadanie?
Cena modelu to stawka za tokeny, a koszt zadania to stawka razy liczba zużytych tokenów. GPT-6 Astra kosztuje 10 USD za milion tokenów wejściowych i 50 USD za milion wyjściowych, Claude Opus 5.5 4 i 20 USD, Claude Sonnet 5.5 2 i 10 USD, a Grok 4.7 2 i 6 USD. Sama stawka potrafi zmylić. Grok 4.7 ma najtańsze tokeny z tej czwórki, a jego przebieg Terminal-Bench 4.0 kosztował 3683 USD, więcej niż GPT-6 Astra na poziomie high (2269 USD), przy wyniku niższym o 20 punktów. Porównujcie koszt zadania, nie cennik.
Jak wypada na Waszym repozytorium?
Weźcie 10–20 zamkniętych zgłoszeń z własnego repozytorium, dajcie je dwóm albo trzem kandydatom i policzcie trzy rzeczy: ile rozwiązań przeszło testy i code review, ile kosztowało jedno zadanie i ile czasu człowiek poprawiał wynik. Taki pilotaż powie o Waszym kodzie więcej niż każdy ranking.
Co to znaczy dla Twojej firmy?
Czołowe modele dzielą dziś w niezależnych testach pojedyncze punkty, a koszt tego samego wyniku potrafi różnić się dwukrotnie. Nie warto więc gonić lidera co miesiąc. Lepiej wybrać narzędzie, które pasuje do Waszych danych i sposobu pracy, i raz na kwartał sprawdzić, czy nowy model robi różnicę na Waszych zadaniach. Pierwszy krok zależy od tego, gdzie jesteście dziś.
| Sytuacja w firmie | Pierwszy krok |
|---|---|
| Programiści używają AI na prywatnych kontach. | Przenieście pracę na plan firmowy, żeby kod podlegał warunkom komercyjnym, i spiszcie, czego nie wolno wklejać. |
| Zespół wybiera między Claude Code a Codexem. | Zróbcie pilotaż na 10–20 zgłoszeniach z własnego repozytorium i porównajcie koszt zadania, nie cenę tokenów. |
| Chcecie swobody zmiany modelu. | Rozważcie narzędzie wielomodelowe, takie jak GitHub Copilot albo Cursor, i ustalcie, kto zatwierdza nowe modele. |
| Agent już działa, ale bez reguł. | Ustawcie centralnie tryb uprawnień i zasadę, że kod od agenta przechodzi code review. |
Jeśli model ma pomagać także poza kodem, w codziennej pracy biurowej, zajrzyjcie do naszego rankingu najlepszych modeli AI. A jeśli zespół już pracuje w Claude Code, następnym krokiem jest poradnik Claude Code: jak pracować dużo szybciej.
Najczęstsze pytania
Według niezależnego testu Terminal-Bench 4.0 (stan na 5 października 2026 r.) prowadzą ex aequo GPT-6 Astra z agentem Codex (58,2%) i Claude Fable 5.1 z agentem Claude Code (57,9%); różnica mieści się w błędzie pomiaru. Anthropic deklaruje wyższe wyniki dla nowych modeli Claude Sonnet 5.5 (70,6%) i Claude Opus 5.5 (66,4%), ale niezależna tablica jeszcze ich nie potwierdziła. W rankingu WebDev Arena, opartym na głosach użytkowników, pierwszy jest Claude Opus 5.5.
W jakości to dziś remis: najlepsza para z Codexem i najlepsza para z Claude Code dzielą w Terminal-Bench 4.0 0,3 punktu. Różnią się kosztem przebiegu, modelami, które obsługują, i ekosystemem. Dla firmy zwykle rozstrzyga to, na jakim planie firmowym już jest (Claude czy ChatGPT) i gdzie pracuje zespół: w terminalu, w IDE czy w przeglądarce.
Od darmowego czatu w przeglądarce: w claude.ai albo chatgpt.com opisz po polsku mały program, a AI napisze kod bez instalowania czegokolwiek. Kiedy chcesz, żeby AI pracowało na plikach na Twoim komputerze, najmniej kroków wymaga aplikacja Claude z zakładką Code (od planu Pro, 17 USD miesięcznie przy płatności rocznej). Codex od OpenAI jest w ograniczonym zakresie także w darmowym planie ChatGPT, w aplikacji na komputer, a GitHub Copilot Free działa za darmo w edytorze VS Code z limitem 2000 podpowiedzi kodu miesięcznie.
SWE-bench to test, w którym agent AI naprawia prawdziwe zgłoszenia z repozytoriów open source, a wynik sprawdzają testy automatyczne. SWE-bench Verified to 500 zadań wyselekcjonowanych przez ludzi; czołowe modele mają w nim ponad 70%. SWE-bench Pro, prowadzony przez Scale AI, ma trudniejsze zadania z repozytoriów na licencjach copyleft: publiczny zestaw to 731 zadań, a rozwiązanie wymaga średnio zmiany 107 linii w 4 plikach. Wyników z obu wariantów nie wolno porównywać ze sobą.
Tak, choć na najtrudniejszych testach zostają w tyle za czołówką. GLM-5.3 firmy Z.ai ma w Terminal-Bench 4.0 41,8%, a DeepSeek-V4.1-Flash, wydany na licencji MIT, deklaruje 31,2%. Na starszej tablicy SWE-bench Verified otwarty MiniMax M2.5 rozwiązał 75,8% zadań za około 0,07 USD na zadanie, prawie tyle co Claude 4.5 Opus (76,8%) za 0,75 USD.
Najczęściej z czterech powodów: inna wersja testu (DeepSeek-V4.1-Flash ma 90,6% w Terminal-Bench 2.1 i 31,2% w wersji 4.0), inny agent, w którym uruchomiono model, inny poziom wysiłku (effort) albo wynik producenta zamiast niezależnego pomiaru. Porównuj liczby tylko w obrębie jednego testu, jednej wersji i najlepiej jednego agenta.
Bardzo często. W drugiej połowie września 2026 r. premiery mieli Grok 4.7 (21 września), Claude Opus 5.5 (22 września) i Claude Sonnet 5.5 (28 września). Dlatego ten ranking aktualizujemy co miesiąc, a każdy wynik ma datę odczytu.
Wybraliście narzędzie i chcecie, żeby zespół z niego korzystał?
Przed warsztatem „Agenci AI” robimy audyt procesów, więc program powstaje na Waszych zadaniach. Po warsztacie wracamy z follow-upem i sprawdzamy, co weszło do codziennej pracy. Prowadzi Adrian Skobiej.
Źródła
Tablice testów oraz plany Claude, ChatGPT i GitHub Copilot sprawdzone 5 października 2026 r., karty i ogłoszenia producentów odczytane 2 października 2026 r.