Stan na 5 października 2026 r. Wszystkie wyniki sprawdziliśmy tego dnia bezpośrednio na tablicach LMArena, Artificial Analysis, ARC Prize i Scale Labs, a zrzuty ekranu w tekście pokazują ten sam stan. Tablica tekstowa LMArena ma wersję z 2 października. Nie przepisujemy wyników z blogów ani z materiałów prasowych. Rankingi zmieniają się co kilka dni, dlatego aktualizujemy ten artykuł co miesiąc. Linki do każdej tablicy są w sekcji „Źródła”.
W skrócie
- Najprostszy start: ranking sprawdzisz sam w minutę na arena.ai/leaderboard/text i artificialanalysis.ai/leaderboards/models, bez konta. Model z czołówki przetestujesz za darmo w Claude: darmowe konto na claude.ai daje Claude Sonnet 5.5, drugi model indeksu Artificial Analysis. Instrukcja krok po kroku jest w sekcji „Jak samemu sprawdzić ranking”.
- Nie ma jednego zwycięzcy. Claude Opus 5.5 prowadzi w indeksie Artificial Analysis (58 pkt) i w programistycznej tablicy Code Arena (1815 pkt), GPT-6 Astra w ARC-AGI-2 (95,0%) i Humanity's Last Exam (54,8%), a Gemini 4 Argon w ogólnej tablicy LMArena (1525 pkt).
- Gemini 4 Argon trafił 30 września 2026 r. tylko do wybranych zespołów cyberbezpieczeństwa. Firma nie kupi go jeszcze ani w API, ani w abonamencie.
- Czołówka jest ciasna: w LMArena 20 najwyżej ocenianych modeli mieści się w 41 punktach (wersja tablicy z 2 października), a ten sam model potrafi zająć kilka miejsc w zależności od ustawień.
- Najlepszy model z otwartymi wagami, MiMo-V2.6-Pro od Xiaomi, ma 46 pkt w indeksie Artificial Analysis, czyli 12 mniej od lidera.
- Cena różni się bardziej niż wynik. GPT-6.1 Sol w wariancie high zdobywa 50 pkt i wykonuje zadanie z indeksu za 0,32 USD. Claude Opus 5.5 w wariancie max ma 58 pkt, ale zadanie kosztuje 5,98 USD, czyli prawie 19 razy więcej.
Który model AI jest najlepszy w 2026?
W październiku 2026 r. najlepszy model AI do pracy umysłowej to według zbiorczego indeksu Claude Opus 5.5 od Anthropic. Jeśli jednak zapytasz użytkowników, które odpowiedzi wolą w rozmowie, wygrywa Gemini 4 Argon od Google. Jeśli zapytasz o rozumowanie na nowych łamigłówkach i najtrudniejsze pytania akademickie, wygrywa GPT-6 Astra od OpenAI. Trzy różne testy dają trzech różnych liderów, bo każdy z nich mierzy coś innego.
Dla firmy, która wybiera narzędzie dziś, pole zawęża się do dwóch modeli. Anthropic podaje, że Claude Opus 5.5 jest dostępny na wszystkich platformach, także w chmurach AWS, Google Cloud i Microsoft Azure. OpenAI zapowiedziało GPT-6 Astra dla planów ChatGPT Plus, Pro, Business i Enterprise oraz w API. Gemini 4 Argon według wpisu Google z 30 września trafia na razie do zaufanych zespołów cyberbezpieczeństwa, a klienci płatnego API i abonenci Google AI Ultra dostaną go dopiero w kolejnym kroku. Model, którego nie da się kupić, może prowadzić w tabeli, ale nie rozwiąże dziś żadnego problemu w Twoim zespole.
Druga rzecz, o której trzeba pamiętać: ta tabela starzeje się szybciej niż jakakolwiek inna. W ostatnich dziesięciu dniach września pojawiły się cztery modele z samej czołówki: Claude Opus 5.5 (22 września), Claude Sonnet 5.5 (28 września), GPT-6.1 Sol (29 września według daty na tablicy ARC Prize) i Gemini 4 Argon (30 września). Ranking z sierpnia nie mówi już nic o tym, co kupić w październiku.
Jak samemu sprawdzić ranking i przetestować zwycięzcę w 5 minut?
Do sprawdzenia rankingu nie potrzebujesz konta ani instalacji, bo tablice są publiczne. Jeden z modeli czołówki przetestujesz potem w darmowym planie. Wystarczą trzy zakładki w przeglądarce.
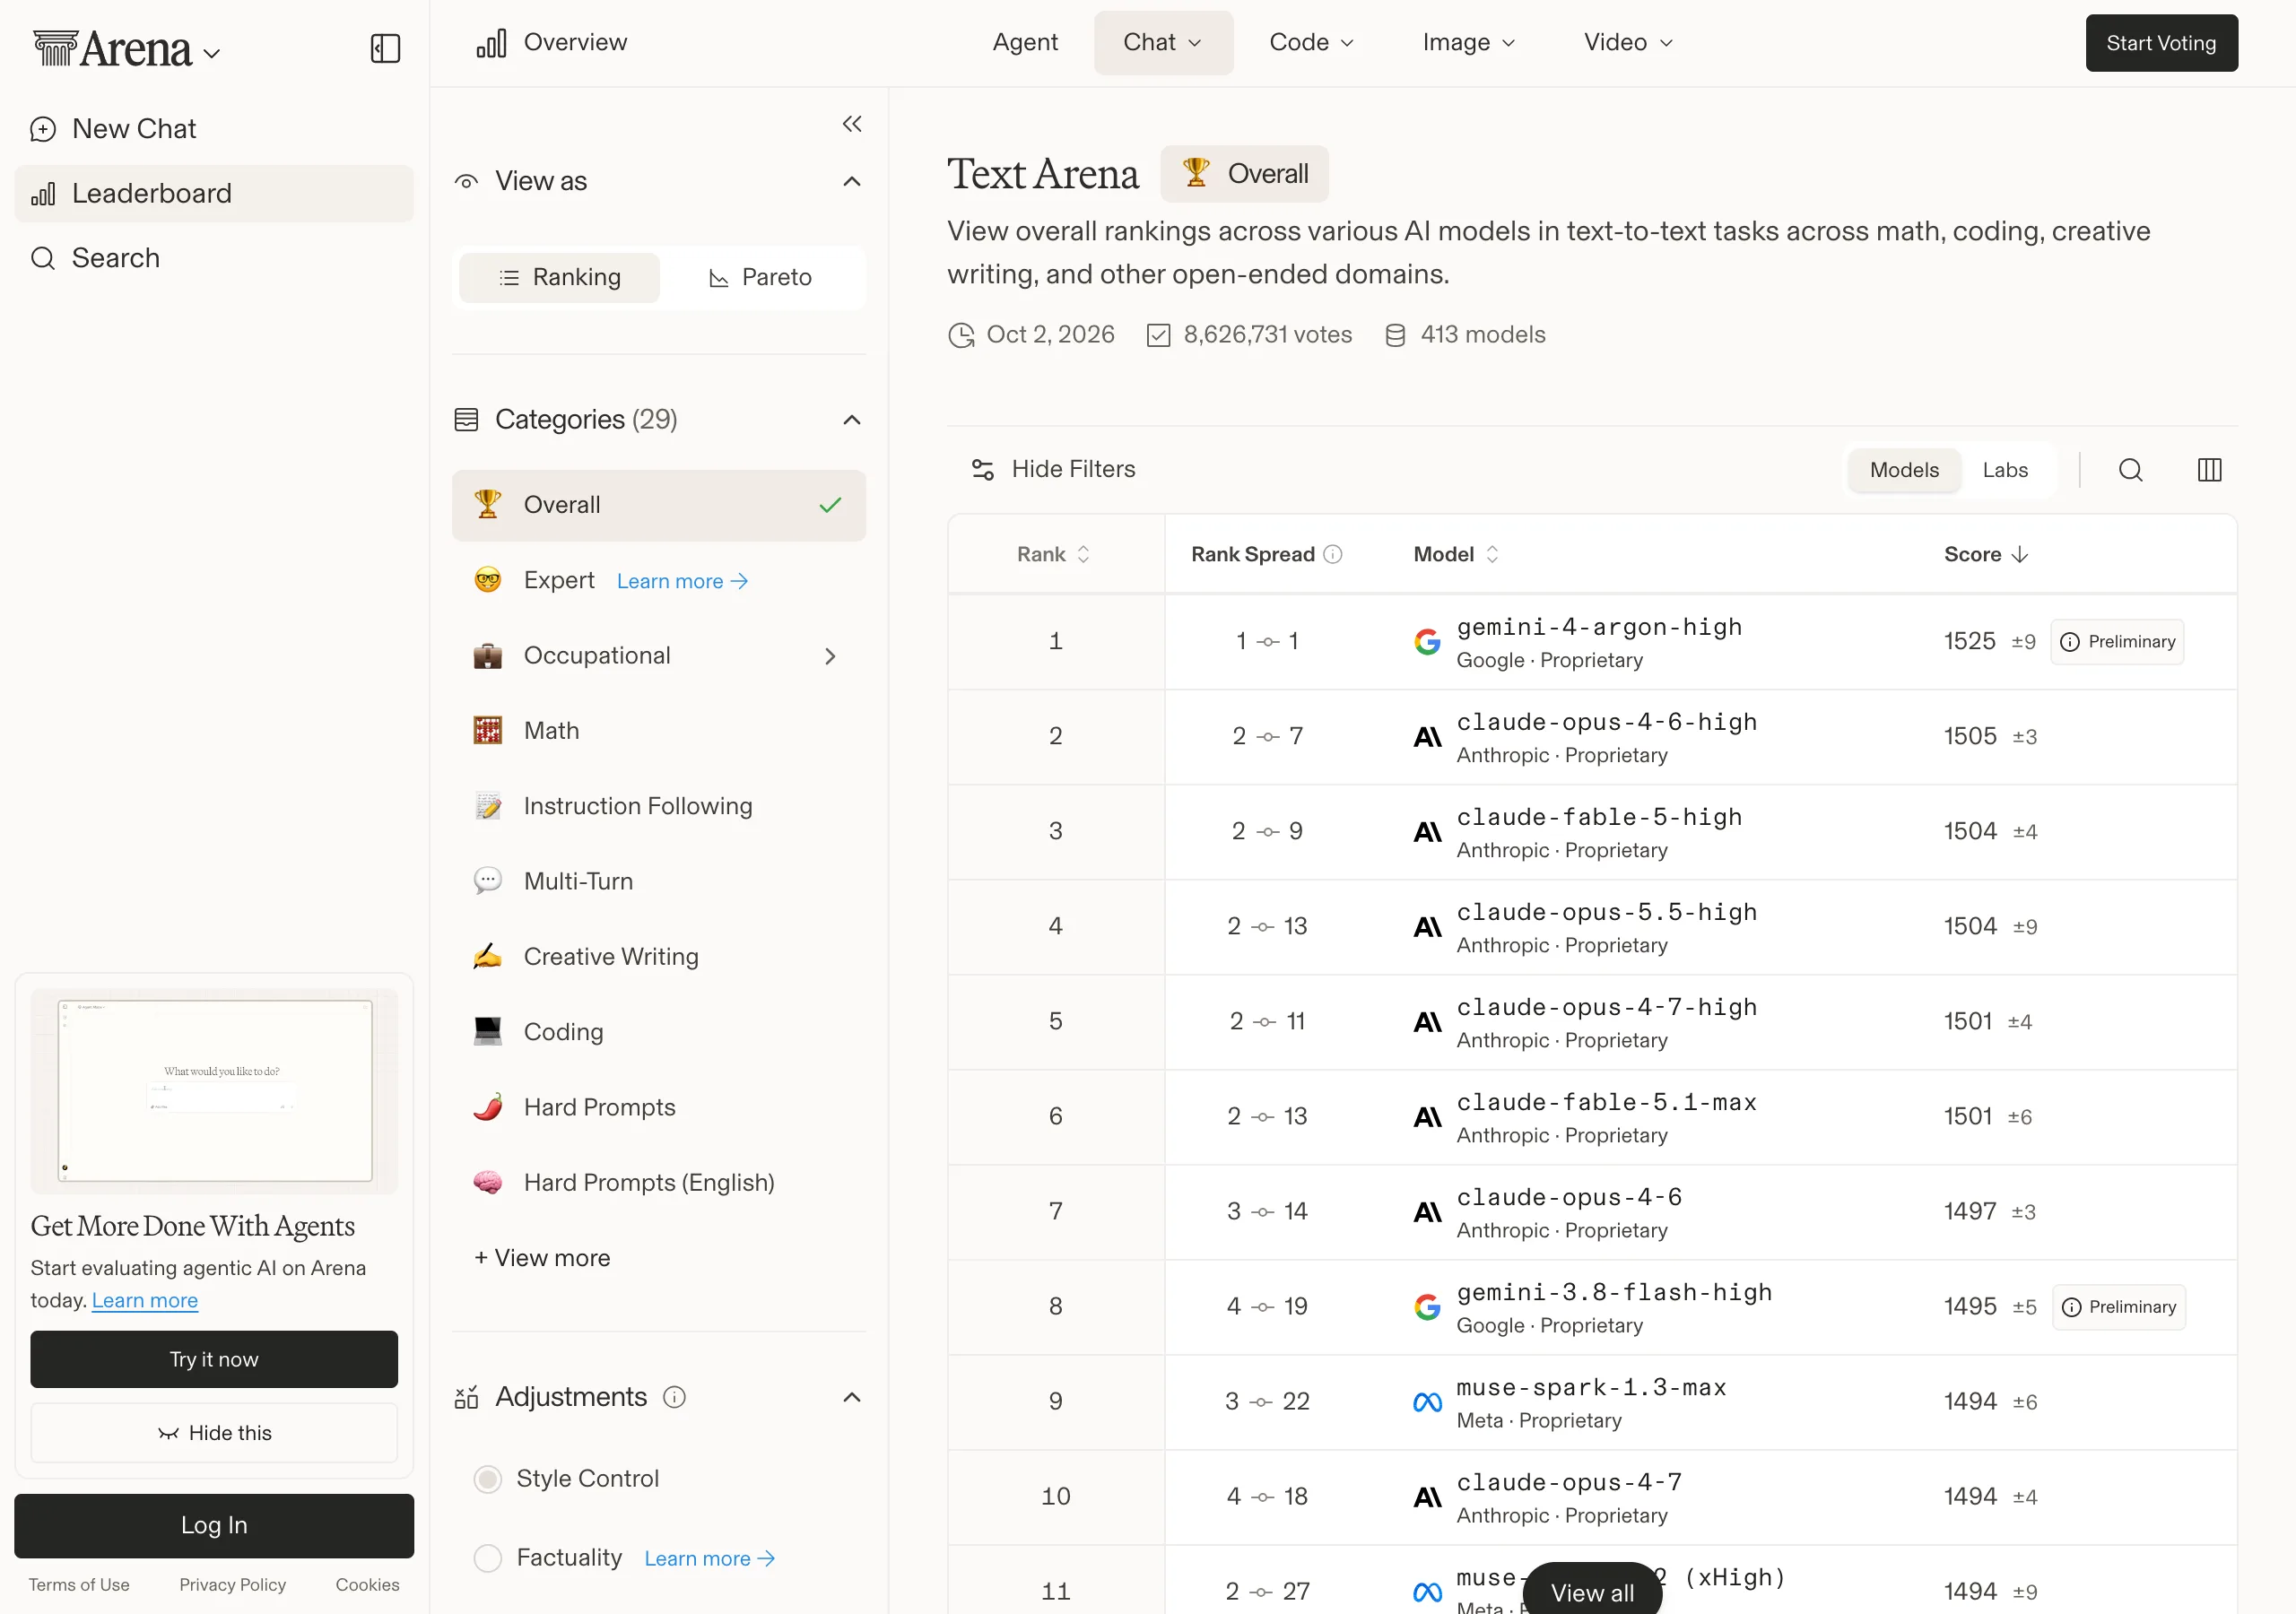
- 1.Otwórz tablicę LMArena. Wejdź na arena.ai/leaderboard/text. Domyślnie widzisz kategorię Overall, czyli wszystkie głosy razem. W lewym panelu „Categories” przełączysz ją na przykład na Coding (programowanie), Math (matematyka) albo Creative Writing (pisanie). Po kliknięciu „View more” pojawia się grupa Language, a w niej Polish, czyli głosy z rozmów po polsku. Zakładka Code na górze strony prowadzi do tablicy programistycznej Code Arena.
- 2.Otwórz indeks Artificial Analysis. Wejdź na artificialanalysis.ai/leaderboards/models. Tabela jest od razu ułożona według indeksu, od najwyższego wyniku. Kliknij nagłówek kolumny Cost per Task, a zobaczysz modele uporządkowane według kosztu jednego zadania. Same modele z otwartymi wagami są na osobnej stronie artificialanalysis.ai/models/open-source.
- 3.Przetestuj model z czołówki za darmo. Najprościej w Claude. Na claude.ai zakładasz darmowe konto i rozmawiasz z Claude Sonnet 5.5. Anthropic podaje, że z tym modelem może rozmawiać każdy, a w indeksie Artificial Analysis ma on 56 punktów w wariancie max, drugi wynik na całej tablicy. Lider, Claude Opus 5.5, według cennika nie jest dostępny w planie Free. Potrzebny jest plan Pro za 20 USD miesięcznie albo 17 USD miesięcznie przy płatności rocznej (ceny bez podatku).
- 4.Porównaj modele w ciemno na arena.ai. Na stronie głównej arena.ai wpisujesz pytanie w trybie Battle i dostajesz odpowiedzi dwóch anonimowych modeli, a nazwy poznajesz dopiero po głosowaniu. Modeli nie wybierasz. Tryb Direct pozwala wybrać model z listy, ale 5 października 2026 r. bez logowania nie było na niej Claude Opus 5.5, GPT-6 Astra ani Gemini 4 Argon. Serwis nadaje się więc do ślepego testu, a konkretnego zwycięzcę sprawdzisz w czacie jego producenta.
W darmowym ChatGPT lidera nie przetestujesz. Według pomocy OpenAI plan Free działa na modelu GPT-5.6 Luna. GPT-6 Astra jest w planie Plus dostępny tylko w ChatGPT Work i Codex, a w zwykłym czacie jako GPT-6 Pro w planach Pro, Business i Enterprise. Gemini 4 Argon nie trafił jeszcze ani do API, ani do abonamentów.
Do takiego testu nie wklejaj danych firmy ani klientów. Arena.ai pisze w odpowiedziach na częste pytania, że rozmowy mogą trafić do publicznych zbiorów badawczych i do dostawców modeli, choć bez danych, które łączyłyby je z Tobą, i prosi, żeby nie wpisywać tam informacji wrażliwych. Darmowe konto Claude to z kolei konto prywatne, a nie firmowe.
Jak czytać rankingi AI (Elo w LMArena vs indeks Artificial Analysis vs testy rozumowania)?
Rankingi AI mierzą trzy różne rzeczy: co ludzie wolą w rozmowie, jak model radzi sobie z zestawem zadań roboczych i jak rozumuje na problemach, których wcześniej nie widział. Zanim spojrzysz na liczby, sprawdź, którą z tych rzeczy mierzy dana tablica, bo od tego zależy, czy jej zwycięzca pasuje do Twojej pracy.
LMArena: ranking czatów AI według głosów użytkowników
LMArena (dziś pod adresem arena.ai) działa jak ślepa degustacja. Użytkownik wpisuje pytanie, dostaje odpowiedzi dwóch anonimowych modeli i wybiera lepszą. Z głosów powstaje punktacja w stylu rankingu Elo znanego z szachów: im częściej model wygrywa pojedynki, tym więcej ma punktów. Tablica tekstowa w wersji z 2 października 2026 r. opiera się na 8 626 731 głosach i obejmuje 413 modeli, więc wynik opiera się na naprawdę dużej próbie.
Przy każdym wyniku stoi liczba po znaku ±, czyli przedział ufności. Claude Opus 5.5 ma 1504 ± 9 punktów, co oznacza, że jego prawdziwy wynik mieści się mniej więcej między 1495 a 1513. W tym samym przedziale leży kilkanaście innych modeli, więc różnica dwóch czy trzech punktów nic nie rozstrzyga. Gemini 4 Argon ma przy wyniku etykietę „Preliminary”, czyli wynik wstępny, bo zebrał dopiero 4932 głosy. Dla porównania Claude Opus 4.6 w wariancie high ma ich 77 636.
Ten ostatni przykład pokazuje też granicę LMArena. Starszy Claude Opus 4.6 ma 1505 punktów, o jeden więcej niż nowszy Claude Fable 5 i nowszy Claude Opus 5.5. Głosujący oceniają pojedynczą odpowiedź w czacie, a w tej konkurencji czołowe modele od dawna piszą na podobnym poziomie. Tablica nie sprawdza, czy model dowiezie wielogodzinne zadanie, policzy arkusz albo poprawi kod w repozytorium.
Artificial Analysis Intelligence Index: zbiorczy test pracy
Artificial Analysis Intelligence Index to zbiorczy wskaźnik niezależnej firmy Artificial Analysis, która sama uruchamia na każdym modelu ten sam zestaw testów. Obecna wersja 4.3.2 łączy 10 testów z wagami: zadania agentowe ważą 30%, kodowanie 20%, rozumowanie naukowe 20%, a wiedza ogólna i praca na dokumentach 30%. W środku są między innymi GDPval-AA (zadania z realnej pracy biurowej), Terminal-Bench 4.0 (programowanie w terminalu), AA-Omniscience (wiedza i skłonność do zmyślania) oraz Humanity's Last Exam.
Po ludzku: spośród omawianych tu tablic ten wynik najbliżej oddaje pracę w firmie. W tabeli zobaczysz przy nazwie modelu dopisek w nawiasie, na przykład max, xhigh albo high. To poziom wysiłku rozumowania, czyli ile model może „myśleć” przed odpowiedzią. Ten sam model ma przez to kilka wierszy, a wyższy poziom zwykle daje lepszy wynik za wyższą cenę.
Przy tym indeksie najłatwiej o pomyłkę z wersjami. OpenAI w materiałach o GPT-6 Astra podaje 61,2 punktu w indeksie w wersji 4.1.1, a na bieżącej tablicy (wersja 4.3.2) ten sam model w wariancie max ma 53 punkty. Nikt tu nie kłamie, po prostu zmieniły się testy i ich wagi. Wyniki z dwóch wersji indeksu nie nadają się do porównania i w tym artykule używamy wyłącznie wersji 4.3.2.
Testy rozumowania: ARC-AGI i Humanity's Last Exam
ARC-AGI to seria testów fundacji ARC Prize, w których model rozwiązuje obrazkowe łamigłówki z regułą do odkrycia. Zadania są nowe, więc nie da się ich wykuć na pamięć. W ARC-AGI-2 panel ludzi rozwiązał według tablicy 100% zadań, co daje dobry punkt odniesienia. Najnowsza wersja ARC-AGI-3 sprawdza, czy agent nauczy się zasad nieznanego, interaktywnego środowiska w trakcie gry.
Humanity's Last Exam (HLE) to 2500 pytań z zamkniętą odpowiedzią, które napisało blisko 1000 ekspertów z ponad 500 instytucji w 50 krajach. Tablicę prowadzi Scale Labs we współpracy z Center for AI Safety. Obok trafności Scale podaje błąd kalibracji, czyli to, jak bardzo deklarowana przez model pewność odbiega od tego, jak często faktycznie ma rację. Dla firmy to praktyczna informacja: model z niskim błędem kalibracji lepiej wie, kiedy nie wie.
Jedna zmiana w tle: od 17 września 2026 r. Center for AI Safety wydaje też HLE-Rolling, czyli wersję testu stale poprawianą na podstawie uwag ekspertów, w której część łatwych pytań zastąpiono trudniejszymi. Tablica Scale, z której bierzemy wyniki, stoi dziś w menu strony w grupie „Legacy”. Wyniki z obu wersji testu nie nadają się do porównania.
Ranking ogólny: kto prowadzi w październiku 2026?
Ranking ogólny opieramy na indeksie Artificial Analysis, bo mierzy wszystkie modele tym samym zestawem zadań roboczych. W tabeli niżej zobaczysz dwanaście najwyżej ocenionych wierszy tablicy w wersji 4.3.2, w tej samej kolejności co na tablicy, z wariantem rozumowania w nawiasie. Przy modelach Anthropic tablica dopisuje do wariantu „with fallback”, a my skracamy to do samego poziomu, na przykład max.
| Model | Producent | Wynik | Test | Źródło |
|---|---|---|---|---|
| Claude Opus 5.5 (max) | Anthropic | 58 pkt | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| Claude Sonnet 5.5 (max) | Anthropic | 56 pkt | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| Claude Opus 5.5 (xhigh) | Anthropic | 56 pkt | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| Claude Opus 5.5 (high) | Anthropic | 54 pkt | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| Claude Fable 5.1 (max) | Anthropic | 53 pkt | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| Claude Fable 5.1 (xhigh) | Anthropic | 53 pkt | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| GPT-6 Astra (max) | OpenAI | 53 pkt | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| Gemini 4 Argon (high) | Google DeepMind | 53 pkt | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| GPT-6 Astra (xhigh) | OpenAI | 52 pkt | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| Claude Sonnet 5.5 (xhigh) | Anthropic | 52 pkt | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| GPT-6.1 Sol (max) | OpenAI | 52 pkt | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| Claude Opus 5.5 (medium) | Anthropic | 51 pkt | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
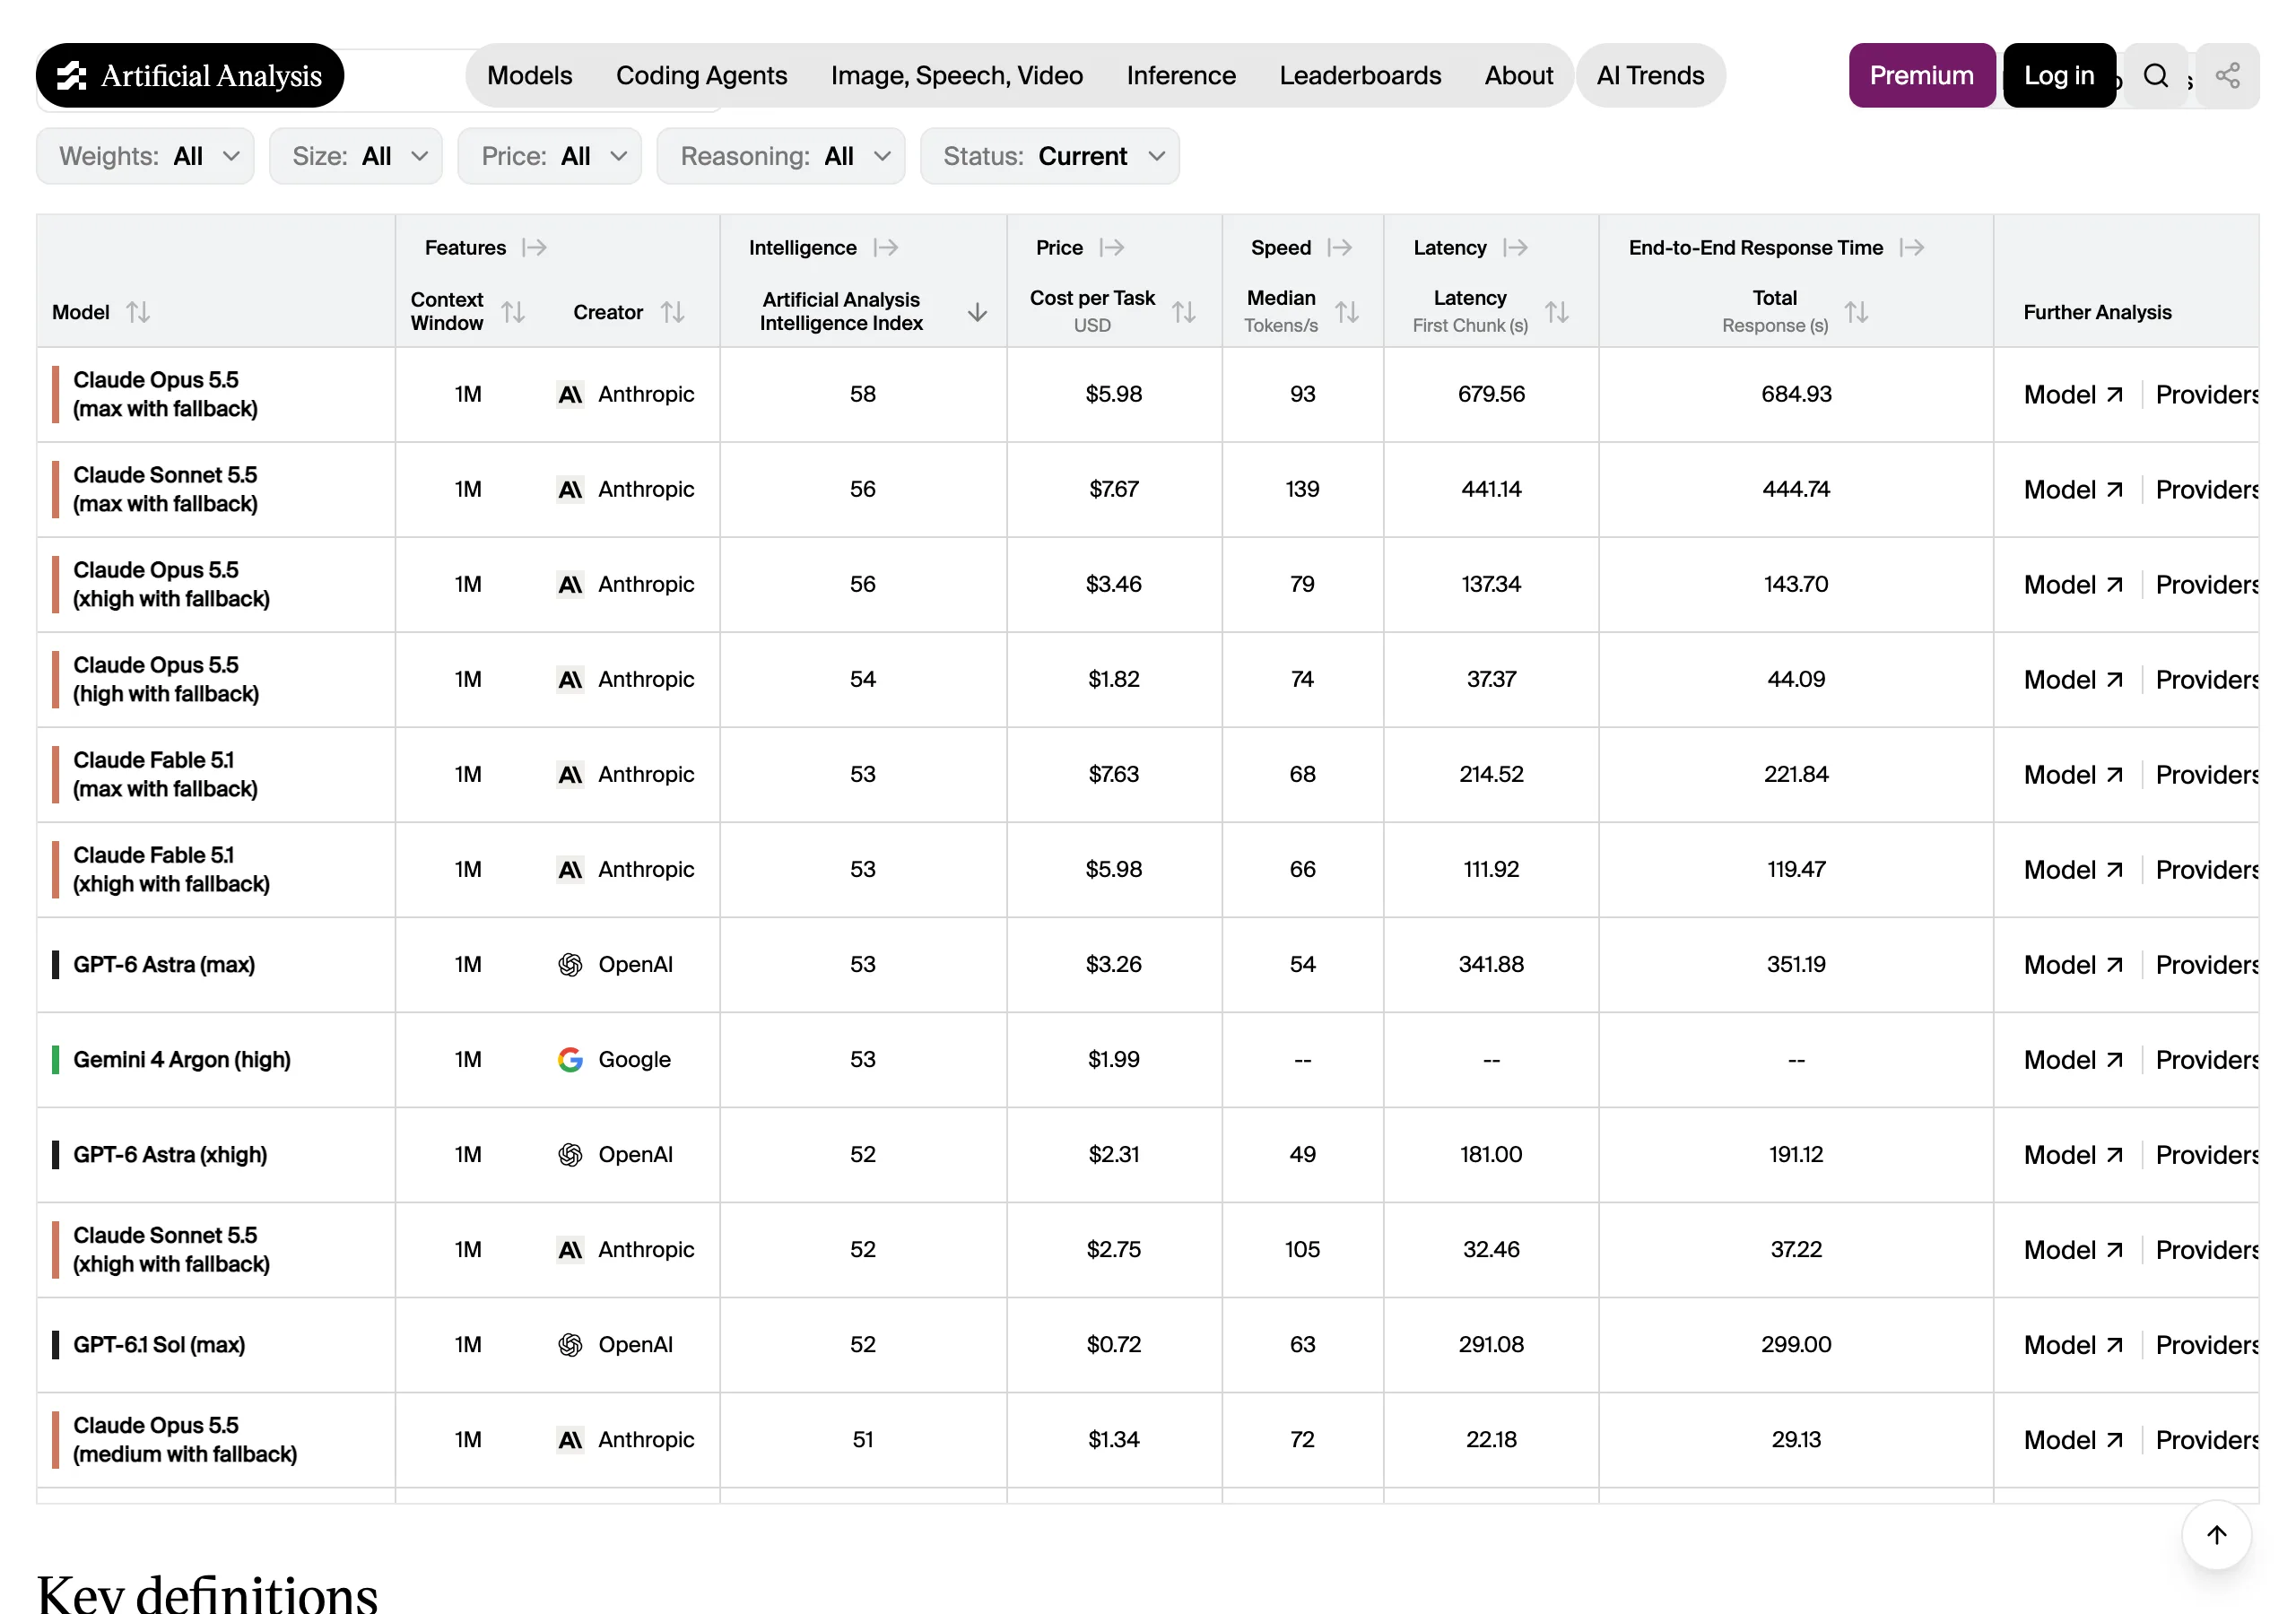
Anthropic zajmuje sześć pierwszych wierszy, ale to w dużej mierze ten sam model w różnych ustawieniach. Jeśli policzyć każdy model raz, w jego najlepszym wariancie, kolejność brzmi: Claude Opus 5.5 (58), Claude Sonnet 5.5 (56), a potem remis trzech modeli z 53 punktami, czyli Claude Fable 5.1, GPT-6 Astra i Gemini 4 Argon. Najlepszy model Mety ma 48 punktów, a xAI 46, więc ci dwaj producenci tracą do lidera 10 i 12 punktów.
Ogólna tablica LMArena układa czołówkę inaczej. W tabeli niżej zobaczysz osiem pierwszych pozycji z widoku domyślnego (kategoria Overall, wersja tablicy z 2 października 2026 r.), z liczbą głosów, która mówi, na ile wynik jest już stabilny. Ten sam widok pokazuje zrzut w sekcji o tym, jak samemu sprawdzić ranking.
| Model | Producent | Wynik | Test | Źródło |
|---|---|---|---|---|
| gemini-4-argon-high | Google DeepMind | 1525 ± 9 pkt, wynik wstępny z 4932 głosów | LMArena Text, Overall | LMArena (arena.ai), tablica z 2.10.2026, odczyt 5.10.2026 |
| claude-opus-4-6-high | Anthropic | 1505 ± 3 pkt z 77 636 głosów | LMArena Text, Overall | LMArena (arena.ai), tablica z 2.10.2026, odczyt 5.10.2026 |
| claude-fable-5-high | Anthropic | 1504 ± 4 pkt z 38 387 głosów | LMArena Text, Overall | LMArena (arena.ai), tablica z 2.10.2026, odczyt 5.10.2026 |
| claude-opus-5.5-high | Anthropic | 1504 ± 9 pkt z 4552 głosów | LMArena Text, Overall | LMArena (arena.ai), tablica z 2.10.2026, odczyt 5.10.2026 |
| claude-opus-4-7-high | Anthropic | 1501 ± 4 pkt z 64 946 głosów | LMArena Text, Overall | LMArena (arena.ai), tablica z 2.10.2026, odczyt 5.10.2026 |
| claude-fable-5.1-max | Anthropic | 1501 ± 6 pkt z 11 800 głosów | LMArena Text, Overall | LMArena (arena.ai), tablica z 2.10.2026, odczyt 5.10.2026 |
| claude-opus-4-6 | Anthropic | 1497 ± 3 pkt z 82 189 głosów | LMArena Text, Overall | LMArena (arena.ai), tablica z 2.10.2026, odczyt 5.10.2026 |
| gemini-3.8-flash-high | Google DeepMind | 1495 ± 5 pkt, wynik wstępny z 26 298 głosów | LMArena Text, Overall | LMArena (arena.ai), tablica z 2.10.2026, odczyt 5.10.2026 |
Między pierwszym a ósmym miejscem jest 30 punktów, a między drugim a siódmym zaledwie 8. W wersji tablicy z 2 października na ósme miejsce wszedł gemini-3.8-flash-high, a muse-spark-1.3-max od Mety (1494 ± 6) spadł na dziewiąte. Najwyżej oceniany wariant GPT-6 Astra (max) ma w tej tablicy 1477 punktów, czyli o 48 mniej niż Gemini 4 Argon, mimo że w testach rozumowania prowadzi. To dobra ilustracja, dlaczego jedna tabela nie wystarczy: LMArena mierzy styl i trafność pojedynczej odpowiedzi, a indeks Artificial Analysis pracę nad zadaniem.
Ranking wskazał dwa modele. Który sprawdzi się u Was?
Na warsztacie Podstawy AI zespół pracuje na ChatGPT, Claude i Gemini na własnych zadaniach. Warsztat trwa 1–2 dni, stacjonarnie lub online, dla grupy do 15 osób.
Najlepsze AI do rozumowania i wiedzy
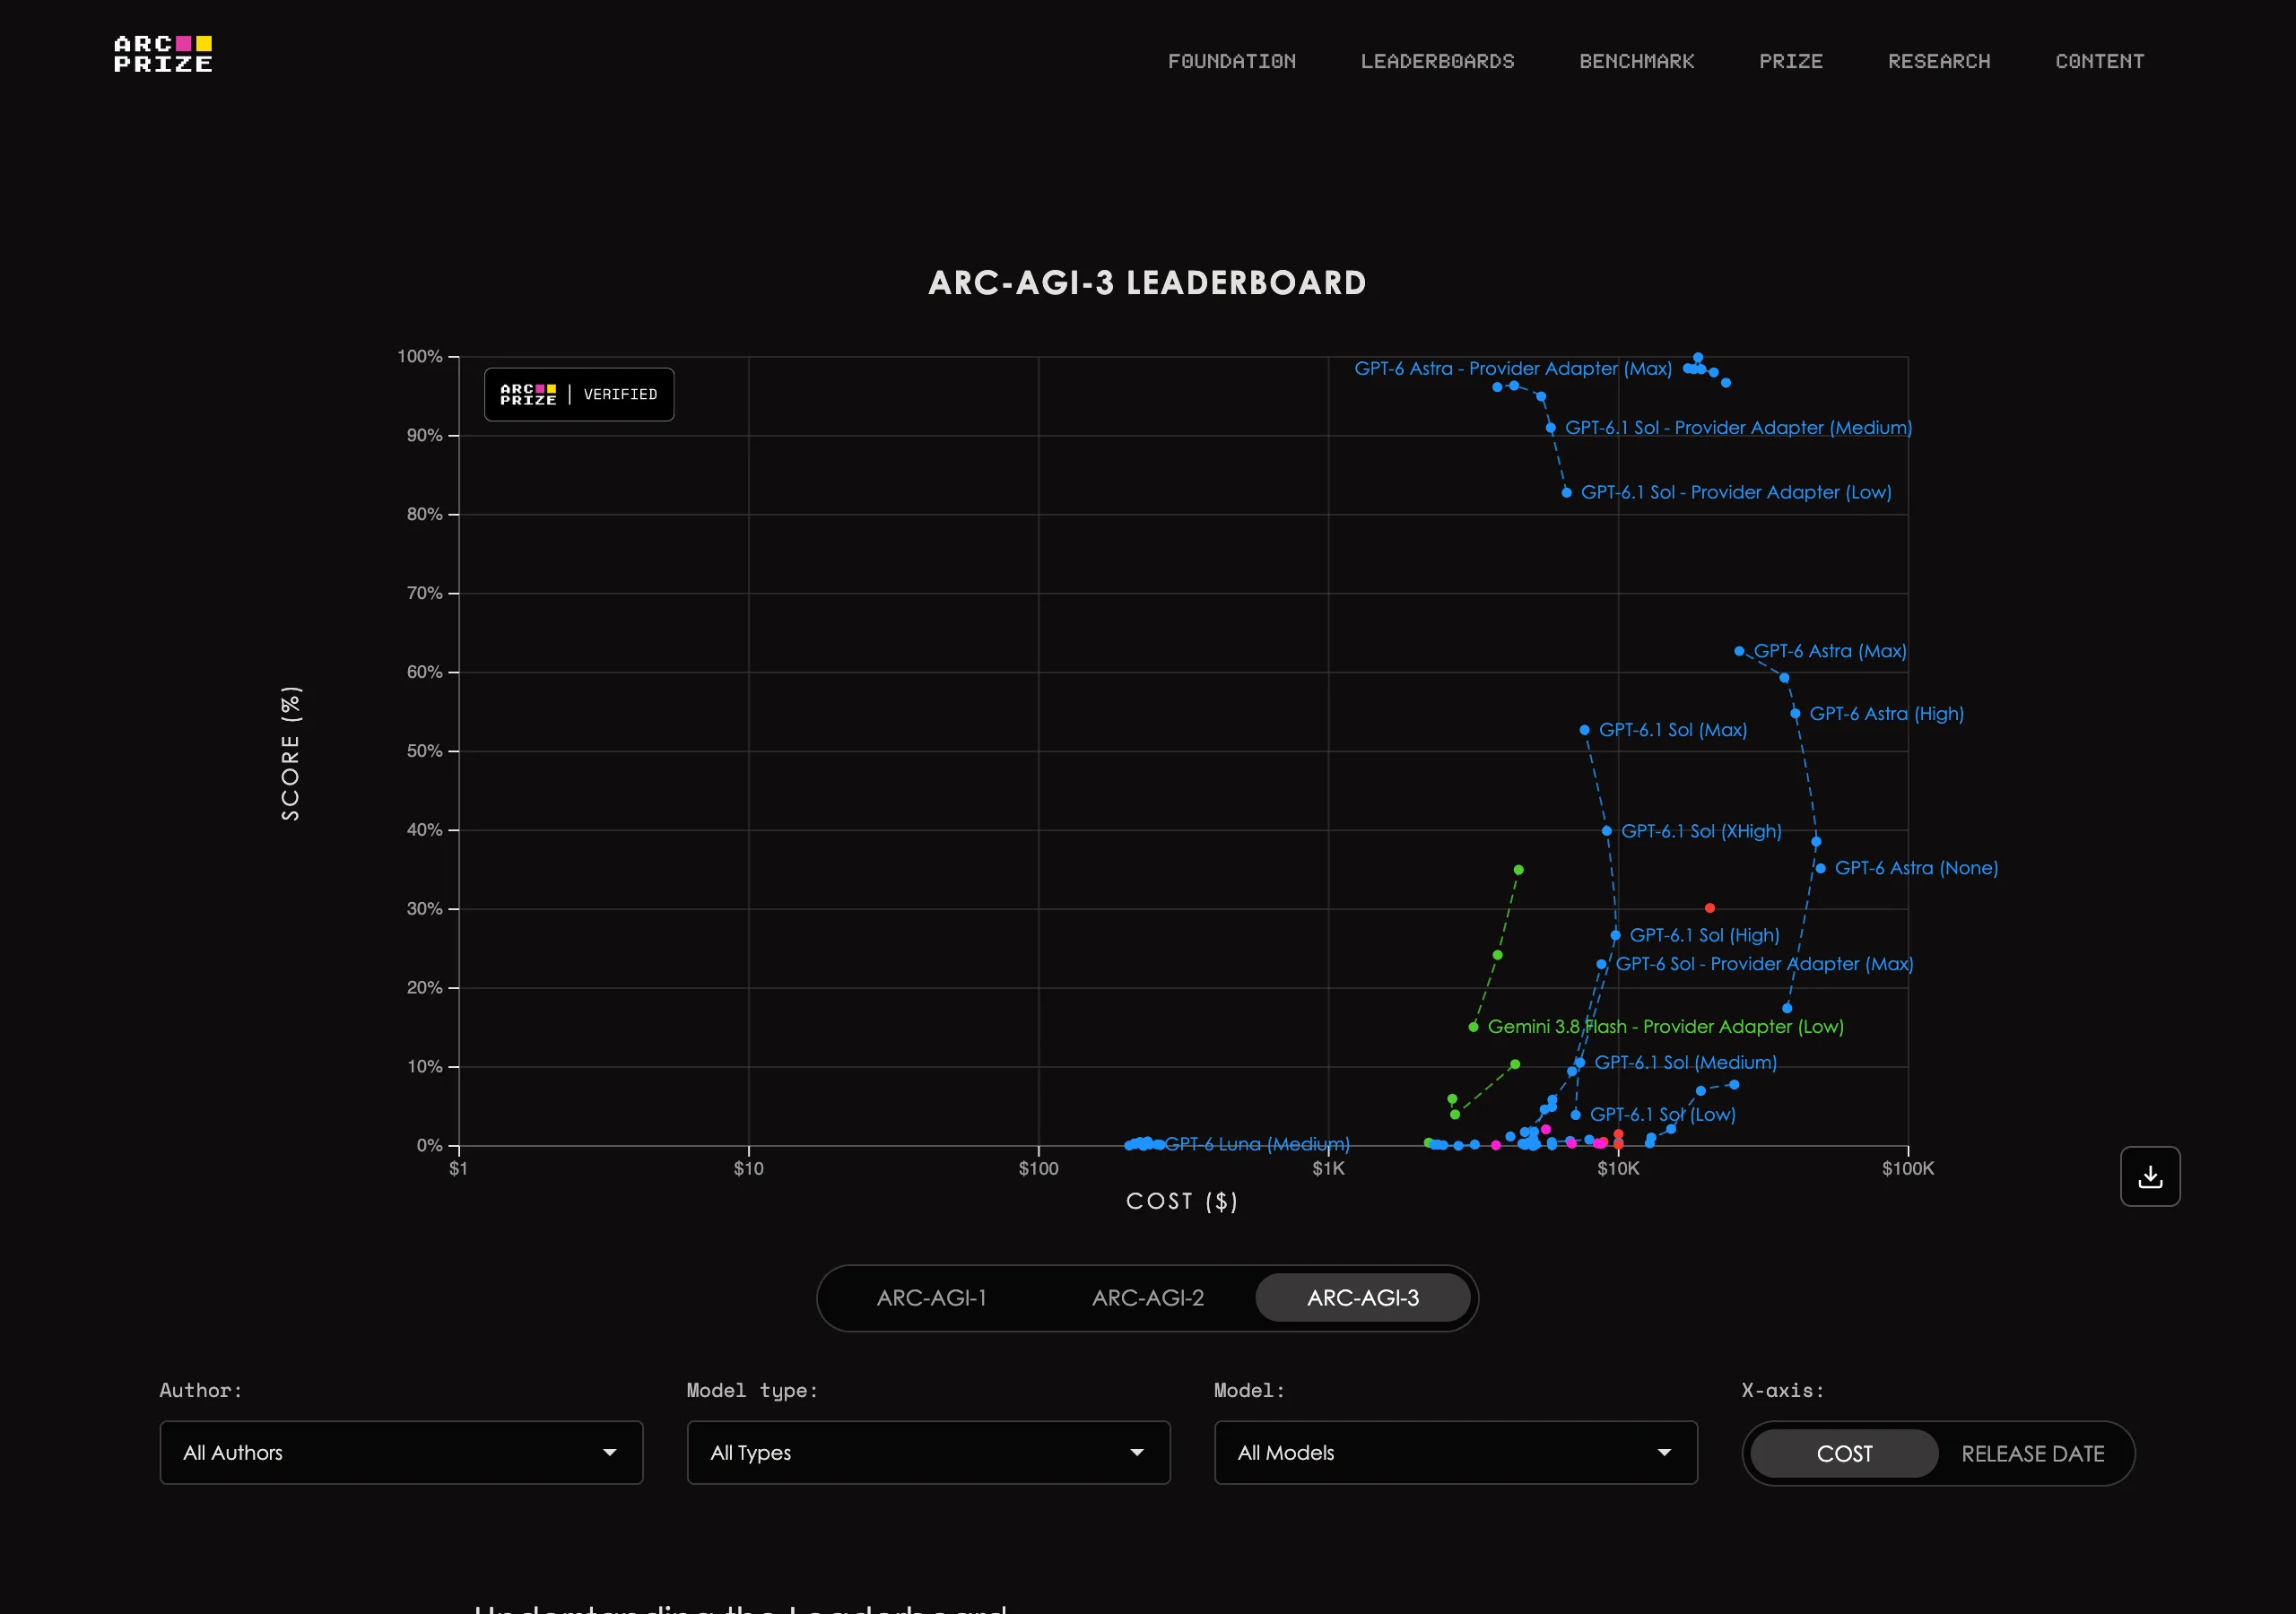
W rozumowaniu i wiedzy akademickiej prowadzi GPT-6 Astra od OpenAI: ma najlepszy wynik w ARC-AGI-2 (95,0%) i w Humanity's Last Exam na tablicy Scale (54,8%). Tuż za nim w ARC-AGI-2 są GPT-6.1 Sol i Claude Opus 5.5. Wykres pokazuje najlepszy wariant każdego modelu w ARC-AGI-2 i koszt jednego zadania podany przez ARC Prize.
Pięć modeli z czołówki rozwiązuje od 89% do 95% zadań, więc ARC-AGI-2 przestaje je od siebie odróżniać. Ciekawszy jest szczegół z tablicy: Claude Opus 5.5 w wariancie high rozwiązał 93,3% zadań, a w wariancie max 91,7%, choć max kosztuje 1,85 USD za zadanie zamiast 0,408 USD. Więcej „myślenia” nie zawsze daje lepszy wynik, a zawsze kosztuje.
W nowszym ARC-AGI-3 widać, jak bardzo wynik zależy od uprzęży, czyli programu, który prowadzi model przez zadanie. GPT-6 Astra (Max) rozwiązuje w standardowej uprzęży ARC Prize 62,7% środowisk, a w uprzęży przygotowanej przez producenta (na tablicy: Provider Adapter) 98,6%. OpenAI w swoim ogłoszeniu podaje 99,9%, a tyle na tablicy ma wariant High właśnie w uprzęży producenta. Claude Opus 5.5 nie ma jeszcze wyniku w ARC-AGI-3, więc tej wersji testu nie używamy do porównań.
Humanity's Last Exam układa czołówkę podobnie. W tabeli niżej zobaczysz sześć pierwszych pozycji tablicy Scale Labs z błędem kalibracji obok trafności. Te same wyniki pokazuje zrzut pod tabelą.
| Model | Producent | Wynik | Test | Źródło |
|---|---|---|---|---|
| GPT 6 Astra | OpenAI | 54,80% ± 1,94 pkt proc., błąd kalibracji 39%, miejsce 1 | Humanity's Last Exam | Scale Labs, odczyt 5.10.2026 |
| Claude Fable 5.1 (xhigh) | Anthropic | 46,50% ± 2,00 pkt proc., błąd kalibracji 20%, miejsce 2 | Humanity's Last Exam | Scale Labs, odczyt 5.10.2026 |
| Gemini 3.1 Pro Preview (thinking high) | Google DeepMind | 46,44% ± 1,96 pkt proc., błąd kalibracji 51%, miejsce 2 | Humanity's Last Exam | Scale Labs, odczyt 5.10.2026 |
| Gemini 3.8 Flash | Google DeepMind | 44,52% ± 1,96 pkt proc., błąd kalibracji 51%, miejsce 2 | Humanity's Last Exam | Scale Labs, odczyt 5.10.2026 |
| GPT-5.4 Pro | OpenAI | 44,32% ± 1,95 pkt proc., błąd kalibracji 38%, miejsce 2 | Humanity's Last Exam | Scale Labs, odczyt 5.10.2026 |
| Muse Spark | Meta | 40,56% ± 1,92 pkt proc., błąd kalibracji 50%, miejsce 4 | Humanity's Last Exam | Scale Labs, odczyt 5.10.2026 |
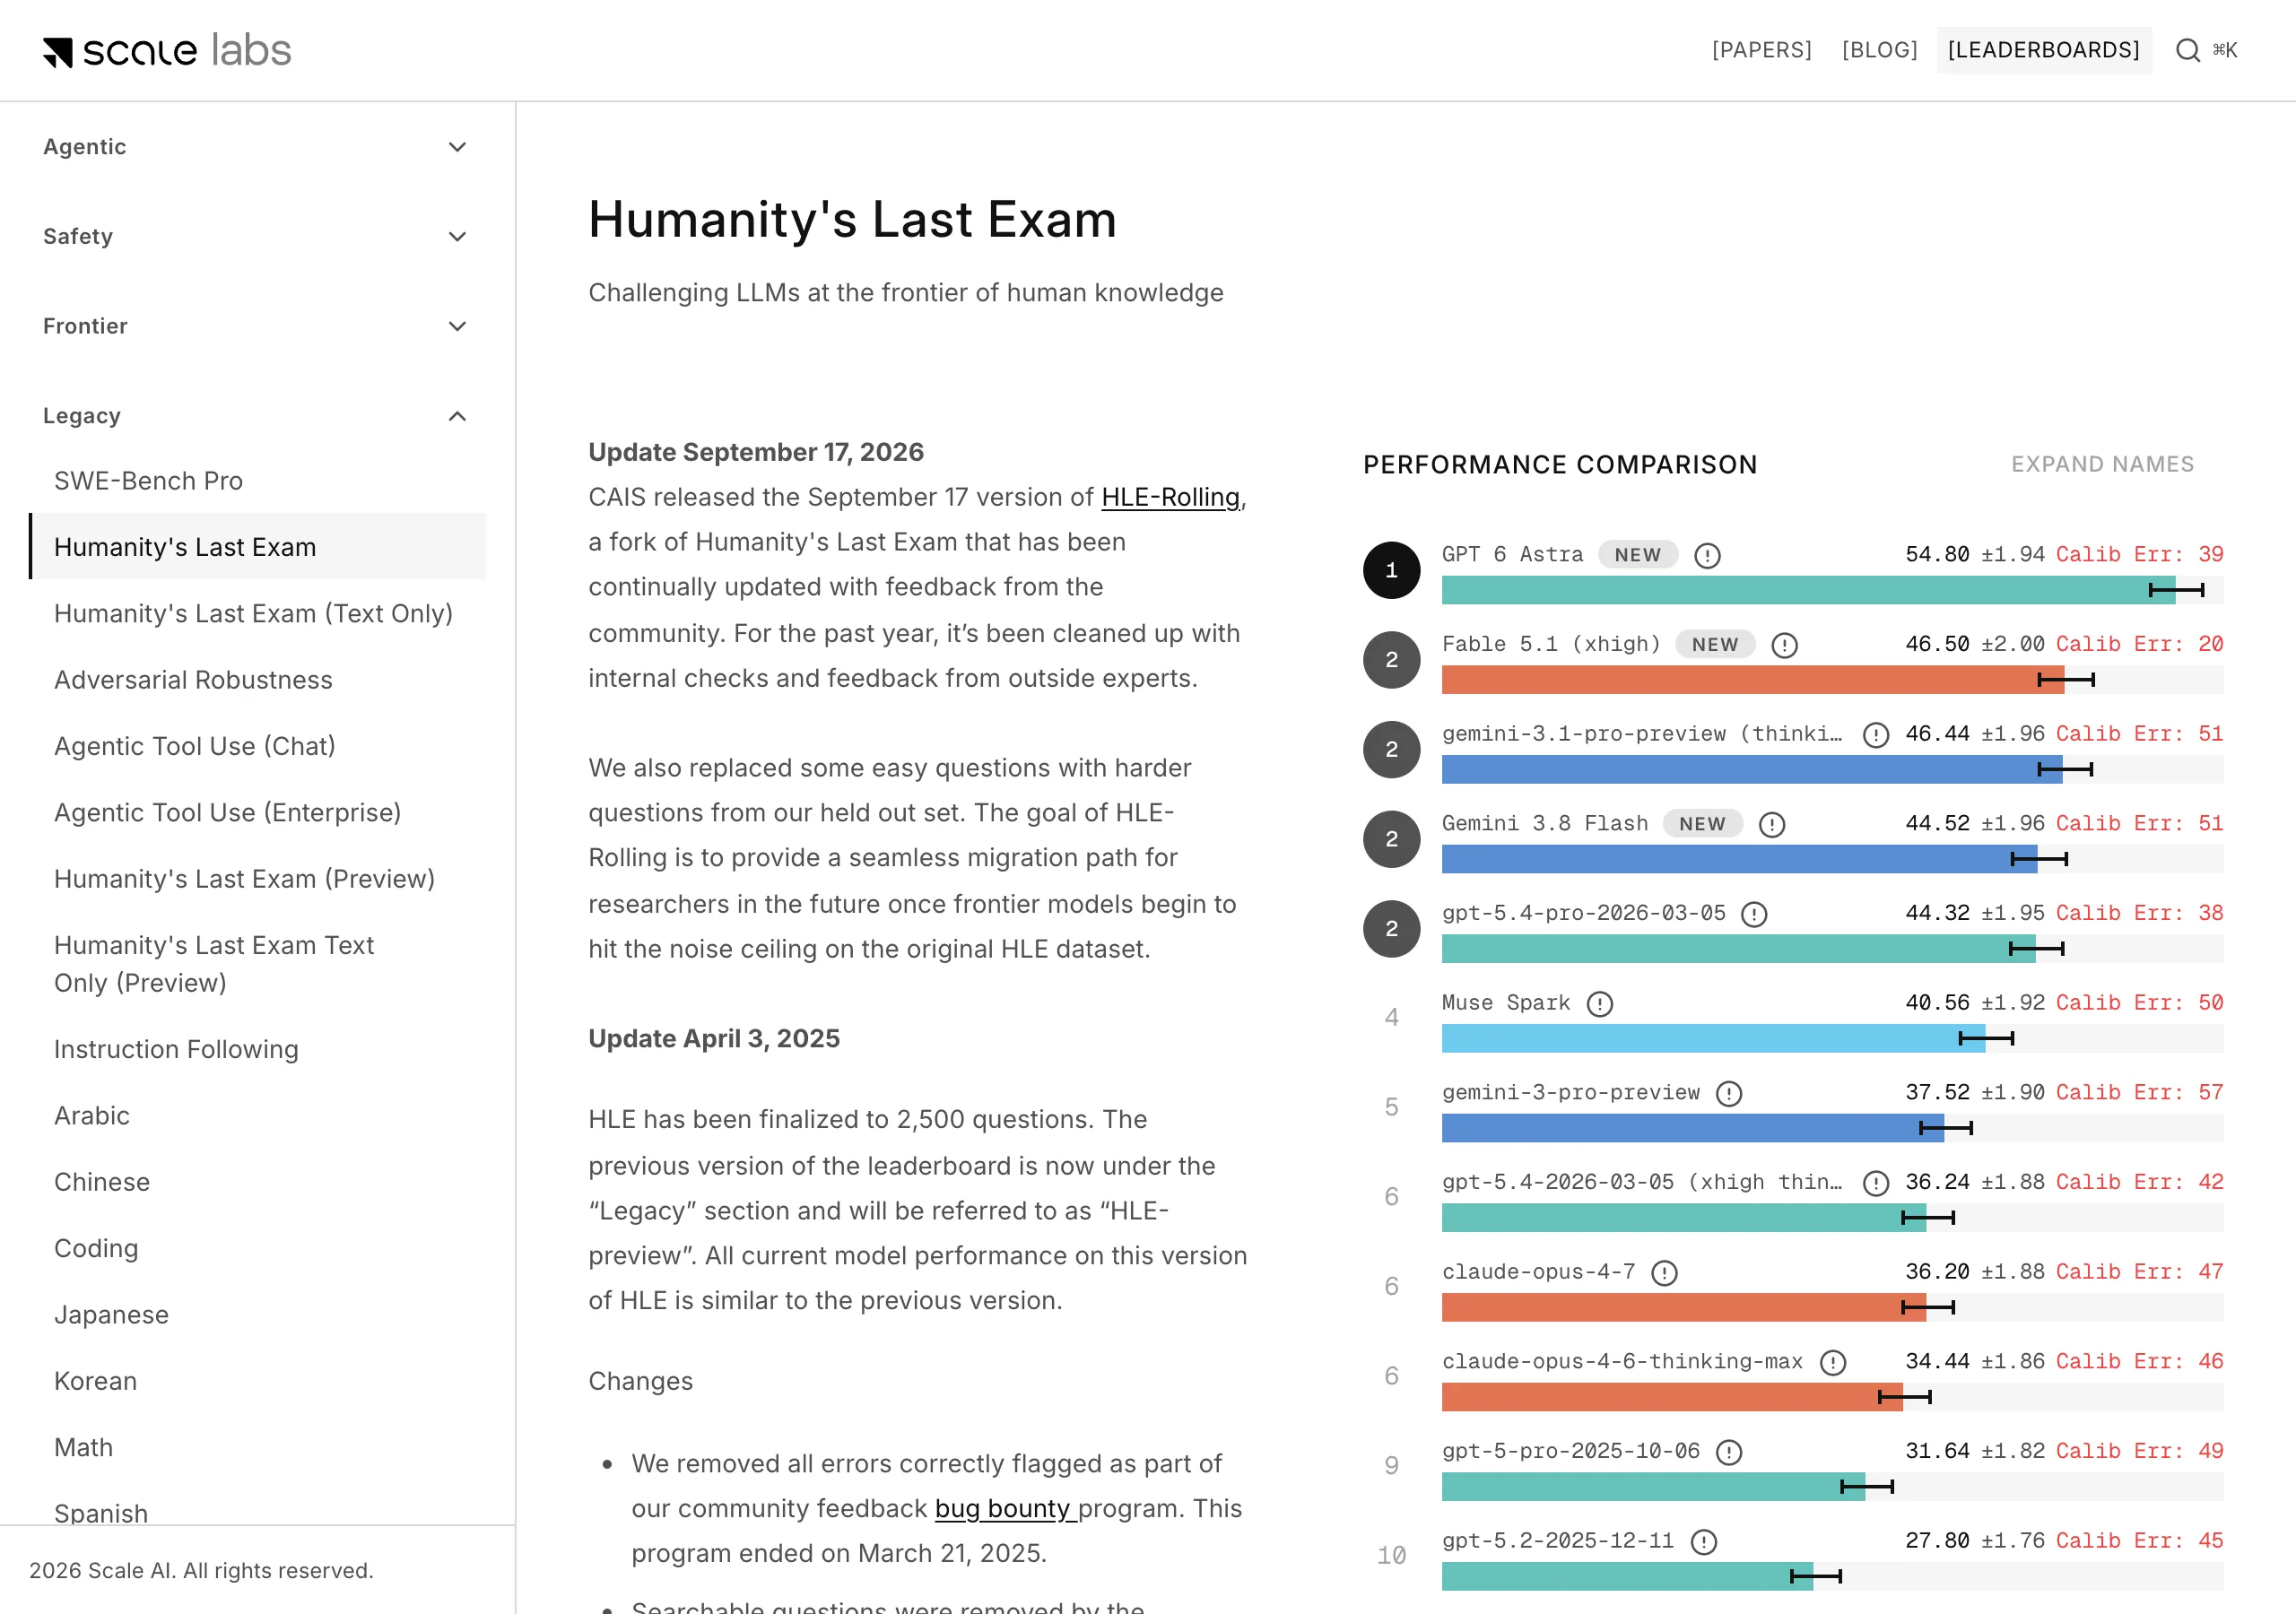
Scale przyznaje to samo miejsce modelom, których przedziały ufności się nakładają, dlatego cztery modele dzielą drugą pozycję. GPT-6 Astra wyprzedza je o ponad 8 punktów procentowych. Claude Fable 5.1 ma za to najniższy błąd kalibracji w czołówce (20%), więc najrzadziej deklaruje pewność, której nie ma. Claude Opus 5.5 i Gemini 4 Argon nie mają jeszcze wyniku na tej tablicy.
Producenci podają w swoich materiałach wyższe liczby, bo mierzą HLE „z narzędziami”. Anthropic podaje dla Claude Opus 5.5 67,7%, a OpenAI dla GPT-6 Astra 57,2%, oba wyniki z narzędziami. To inna konfiguracja niż na tablicy Scale, więc tych liczb nie wstawiamy do tabeli.
Najlepsze AI do kodowania
W programowaniu stron i aplikacji prowadzi Claude Opus 5.5. W Code Arena (część WebDev, aktualizacja z 1 października 2026 r.) wariant max ma 1815 ± 16 punktów, GPT-6 Astra (max) 1788 ± 10, a Claude Sonnet 5.5 (xhigh) 1786 ± 18. Przedziały dwóch ostatnich na siebie zachodzą, więc o drugie miejsce toczy się realna walka. Programowanie to osobny temat z własnymi testami i narzędziami, dlatego rozkładamy go w rankingu najlepsze AI do programowania.
Najlepsze modele otwarte (open weights)
Model z otwartymi wagami (open weights) to według definicji Artificial Analysis taki, którego pliki można pobrać, uruchomić na własnej infrastrukturze i dostroić. Najlepszy z nich to w październiku 2026 r. MiMo-V2.6-Pro od Xiaomi. W tabeli niżej zobaczysz sześć najwyżej ocenionych modeli otwartych z liczbą parametrów. W pięciu pierwszych przy każdej odpowiedzi pracuje tylko część parametrów, nazywana na tablicy parametrami aktywnymi.
| Model | Producent | Wynik | Test | Źródło |
|---|---|---|---|---|
| MiMo-V2.6-Pro | Xiaomi | 46 pkt; 1,0 bln parametrów, 42 mld aktywnych | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| GLM-5.3 (Max) | Z AI | 45 pkt; 753 mld parametrów, 40 mld aktywnych | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| Kimi K3 (Max) | Moonshot AI (na tablicy jako Kimi) | 44 pkt; 2,8 bln parametrów, 104 mld aktywnych | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| GLM 5.3 Flash | Z AI | 42 pkt; 320 mld parametrów, 18 mld aktywnych | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| DeepSeek V4.1 Flash (Max) | DeepSeek | 39 pkt; 552 mld parametrów, 16 mld aktywnych | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
| Qwen3.8 27B (Xhigh) | Alibaba | 34 pkt; 27 mld parametrów | Intelligence Index v4.3.2 | Artificial Analysis, odczyt 5.10.2026 |
Najlepszy model otwarty traci do lidera całego rankingu 12 punktów, a cała szóstka pochodzi od chińskich firm. Zachodni producenci wypadają w tej kategorii słabo: najlepszy otwarty model Mety, Muse Glimmer (High), ma 17 punktów, europejski Mistral Medium 3.5 ma 14, a gpt-oss-120b (High) od OpenAI 12. W LMArena modele otwarte też trzymają się blisko czołówki: kimi-k3-max ma 1488 punktów, mimo-v2.6-pro 1480, a glm-5.3-max 1478.
Dla firmy model otwarty ma sens wtedy, gdy dane nie mogą opuścić własnej infrastruktury albo gdy skala użycia uzasadnia własne serwery. Model z bilionem parametrów nie zmieści się na laptopie, więc „za darmo” dotyczy tylko licencji.
Ranking a cena: które modele dają najwięcej za pieniądze
Artificial Analysis podaje przy każdym modelu koszt zadania (Cost per Task), czyli średni koszt w dolarach wykonania jednego zadania z indeksu, policzony z cen tokenów i faktycznego zużycia. Token to kawałek słowa, za który płaci się w API. Ten wskaźnik jest uczciwszy od samej ceny za milion tokenów, bo model, który dużo „myśli”, zużywa ich więcej. W tabeli niżej zobaczysz wynik i koszt zadania dla wybranych modeli.
| Model | Producent | Wynik | Koszt zadania | Źródło |
|---|---|---|---|---|
| Claude Opus 5.5 (max) | Anthropic | 58 pkt | 5,98 USD | Artificial Analysis, odczyt 5.10.2026 |
| Claude Opus 5.5 (high) | Anthropic | 54 pkt | 1,82 USD | Artificial Analysis, odczyt 5.10.2026 |
| Gemini 4 Argon (high) | Google DeepMind | 53 pkt | 1,99 USD | Artificial Analysis, odczyt 5.10.2026 |
| GPT-6 Astra (max) | OpenAI | 53 pkt | 3,26 USD | Artificial Analysis, odczyt 5.10.2026 |
| GPT-6.1 Sol (max) | OpenAI | 52 pkt | 0,72 USD | Artificial Analysis, odczyt 5.10.2026 |
| GPT-6.1 Sol (high) | OpenAI | 50 pkt | 0,32 USD | Artificial Analysis, odczyt 5.10.2026 |
| MiMo-V2.6-Pro | Xiaomi | 46 pkt | 0,13 USD | Artificial Analysis, odczyt 5.10.2026 |
| DeepSeek V4.1 Flash (max) | DeepSeek | 39 pkt | 0,27 USD | Artificial Analysis, odczyt 5.10.2026 |
Z tej tabeli wynikają trzy wnioski. Ostatnie punkty indeksu są bardzo drogie: Claude Opus 5.5 w wariancie max ma o 4 punkty więcej niż w wariancie high, ale zadanie kosztuje ponad trzy razy więcej. GPT-6.1 Sol w wariancie high daje 50 punktów za 0,32 USD, czyli prawie 19 razy taniej niż lider. MiMo-V2.6-Pro z 46 punktami za 0,13 USD to najtańsza droga do wyniku z górnej połowy tablicy.
Ceny API od producentów potwierdzają ten obraz. Claude Opus 5.5 kosztuje według Anthropic 4 USD za milion tokenów wejściowych i 20 USD za milion wyjściowych, GPT-6 Astra według OpenAI 10 i 50 USD, a Gemini 4 Argon ma według Google startować od ceny promocyjnej 2 i 10 USD. W abonamencie za stanowisko liczy się co innego, czyli cena planu i limity, co porównujemy w artykule Claude czy ChatGPT dla firmy.
Dlaczego ranking to nie wszystko w firmie
Ranking mówi, który model jest najmocniejszy w laboratorium. Firma kupuje coś innego: narzędzie, które jej ludzie będą codziennie otwierać, które zna jej dane i mieści się w budżecie. Pięć rzeczy z tabel nie wyczytasz.
Polszczyzna. Żadna z tablic w tym zestawieniu nie jest testem języka polskiego. LMArena ma wprawdzie kategorię Polish, ale stoi za nią około 2% głosów tablicy tekstowej i nie ma w niej jeszcze najnowszych modeli. Model, który prowadzi w HLE, może pisać sztywniej po polsku niż model z piątego miejsca. Jak to sprawdzić, opisujemy w artykule najlepszy model AI po polsku.
Dane. Liczy się, czy dostawca trenuje na Waszych rozmowach, gdzie je trzyma i czy podpisze umowę powierzenia. Anthropic podaje, że Claude Opus 5.5 jest dostępny z opcją zerowego przechowywania danych, a OpenAI zapowiada to samo dla uprawnionych klientów API przy GPT-6 Astra. To warunki dla API, a w planach aplikacji trzeba je sprawdzić osobno.
Integracje. Model jest tak dobry, jak dostęp do Waszej poczty, dysku, CRM-u i kalendarza. Słabszy model podłączony do dokumentów zespołu często zrobi więcej niż najlepszy model, do którego trzeba wszystko wklejać ręcznie. Przegląd narzędzi i ich integracji znajdziesz w przewodniku narzędzia AI dla firm.
Cena za stanowisko. Abonament płacisz za każdą osobę co miesiąc, więc przy całym zespole różnica w cenie planu szybko przerasta różnicę kilku punktów w indeksie. Zanim kupisz najdroższy wariant, sprawdź na swoich zadaniach, czy tańszy model z czołówki nie daje tego samego efektu.
Margines błędu. Sam Anthropic pisze w ogłoszeniu Claude Opus 5.5, że przy obecnym poziomie modeli różnice w benchmarkach coraz słabiej przekładają się na różnice w realnej pracy, a dystans między Opusem 5.5 a Fable 5.1 w ich codziennym użyciu jest mniejszy, niż sugerują wyniki. Jeśli producent lidera mówi to o własnym modelu, ranking traktuj jako listę kandydatów, a nie jako werdykt.
Co to znaczy dla Twojej firmy
Ranking służy do skrócenia listy, a decyzję podejmujesz na własnych zadaniach. W praktyce wystarczą cztery kroki.
- Wybierz dwóch kandydatów, których da się kupić. W październiku 2026 r. to Claude Opus 5.5 i GPT-6 Astra, a przy ciasnym budżecie GPT-6.1 Sol. Gemini 4 Argon dopisz do listy, gdy Google udostępni go w API i abonamentach.
- Przetestuj je przez tydzień na pięciu prawdziwych zadaniach. Weź to, co zespół robi co tydzień: ofertę, podsumowanie spotkania, analizę arkusza, odpowiedź klientowi po polsku. Zapisuj czas do gotowego wyniku i liczbę poprawek.
- Sprawdź warunki, zanim wybierzesz zwycięzcę. Plan dla firm, trening na danych, umowa powierzenia, integracje z Waszymi narzędziami i cena za stanowisko dla całego zespołu.
- Wracaj do rankingu raz w miesiącu. Każda zmiana narzędzia to dla zespołu nowe nawyki i nowe ustawienia, więc ma sens dopiero przy wyraźnej przewadze.
Najtrudniejszy jest krok drugi, bo wymaga zadań, kryteriów i ludzi, którzy wiedzą, jak sprawdzać modele. Na warsztacie Podstawy AI robimy to razem z zespołem: zaczynamy od audytu procesów, potem uczymy pracy z modelami na Waszych zadaniach, a po warsztacie robimy follow-up i sprawdzamy, co weszło do codziennej pracy. Warsztat prowadzi Adrian Skobiej.
Chcesz, żeby zespół sam umiał wybrać i sprawdzić model?
Warsztat Podstawy AI: 1–2 dni, stacjonarnie lub online, do 15 osób, z audytem procesów na starcie i follow-upem po szkoleniu.
Najczęstsze pytania
To zależy od testu. W zbiorczym indeksie Artificial Analysis (wersja 4.3.2) prowadzi Claude Opus 5.5 od Anthropic z wynikiem 58 punktów. W głosowaniu użytkowników LMArena pierwszy jest Gemini 4 Argon od Google (1525 punktów, wynik wstępny), ale tego modelu firma nie kupi jeszcze ani w API, ani w abonamencie. W testach rozumowania ARC-AGI-2 i Humanity's Last Exam prowadzi GPT-6 Astra od OpenAI. Spośród modeli, które firma może dziś kupić, czołówkę tworzą Claude Opus 5.5 i GPT-6 Astra. Stan na 5 października 2026 r.
LMArena pokazuje dwóm anonimowym modelom to samo pytanie, a użytkownik wybiera lepszą odpowiedź. Z milionów takich głosów powstaje punktacja podobna do rankingu Elo w szachach. Liczba po znaku ± to przedział ufności: jeśli przedziały dwóch modeli na siebie zachodzą, tablica nie rozstrzyga, który jest lepszy. Wynik mówi, czyje odpowiedzi ludzie częściej woleli w rozmowie. Nie mówi, który model lepiej wykona długie zadanie w firmie.
Najprościej w darmowym planie Claude. Na claude.ai zakładasz darmowe konto i rozmawiasz z Claude Sonnet 5.5, czyli modelem, który w indeksie Artificial Analysis zajmuje drugie miejsce (56 pkt w wariancie max). Lider indeksu, Claude Opus 5.5, wymaga planu Pro. Darmowy ChatGPT działa na modelu GPT-5.6 Luna, a GPT-6 Astra jest tylko w planach płatnych. Na arena.ai porównasz za darmo dwa anonimowe modele, ale nie wybierzesz, które to będą. Stan na 5 października 2026 r.
Tylko w jednym miejscu i w małej skali. Humanity's Last Exam i testy z indeksu Artificial Analysis mierzą wiedzę, rozumowanie i pracę agentów, ARC-AGI to zagadki obrazkowe, a ogólna tablica LMArena łączy głosy we wszystkich językach. LMArena ma jednak osobną kategorię Polish (w panelu kategorii: Language, potem Polish). 5 października 2026 r. stało za nią 168 855 głosów, czyli około 2% wszystkich głosów tablicy tekstowej, a przy liderze rozrzut możliwych miejsc wynosił od 1 do 44. Najnowszych modeli, takich jak Claude Opus 5.5, GPT-6 Astra i Gemini 4 Argon, w tej kategorii jeszcze nie było. Jakość po polsku i tak trzeba sprawdzić na własnych tekstach. Omawiamy to w artykule o najlepszym modelu AI po polsku.
Według Artificial Analysis najwyżej stoi MiMo-V2.6-Pro od Xiaomi z wynikiem 46 punktów w indeksie, tuż przed GLM-5.3 od Z AI (45) i Kimi K3 od Moonshot (44). Lider całego rankingu ma 58 punktów, więc najlepszy model otwarty traci do niego 12 punktów. Model z otwartymi wagami można pobrać i uruchomić na własnych serwerach, co ma znaczenie, gdy dane nie mogą opuścić firmy.
Bo mierzą w innych warunkach. Producent sam dobiera ustawienia, poziom rozumowania, narzędzia i wersję testu. OpenAI podaje dla GPT-6 Astra 61,2 punktu w indeksie Artificial Analysis w wersji 4.1.1, a w obecnej wersji 4.3.2 ten sam model ma 53 punkty. Obie liczby są prawdziwe, ale nie wolno ich porównywać. Dlatego w rankingu bierzemy wyniki z tablic, które mierzą wszystkie modele tak samo.
Co kilka dni. W ostatnich dziesięciu dniach września 2026 r. pojawiły się cztery modele z samej czołówki: Claude Opus 5.5 (22 września), Claude Sonnet 5.5 (28 września), GPT-6.1 Sol (29 września, według daty na tablicy ARC Prize) i Gemini 4 Argon (30 września). Tablica LMArena dostała nową wersję już 2 października. Ranking sprzed miesiąca jest więc nieaktualny, dlatego ten artykuł aktualizujemy co miesiąc.