Stan na 5 października 2026 r. Tego dnia odczytaliśmy ponownie wszystkie tablice wyników (PLCC autorzy ostatnio zaktualizowali 1 października), a ranking aktualizujemy co miesiąc. Wyniki przepisujemy wyłącznie z oficjalnych tablic i publikacji naukowych, nie mieszamy wersji testów, a modelu bez oficjalnego wyniku nie wpisujemy. Nazwy modeli podajemy tak, jak zapisali je autorzy tablic.
W skrócie
- Najprostszy start: wklejcie to samo polskie polecenie z codziennej pracy, bez danych firmy, do czatu Bielika na chat.bielik.ai (logowanie kontem Google, LinkedIn albo GitHub) i do darmowych planów ChatGPT, Claude i Gemini. Gdy położycie odpowiedzi obok siebie, od razu zobaczycie, który model pisze naturalniej.
- W teście PLCC prowadzą Gemini 3.1 Pro Preview i Gemini 3.8 Flash (po 97,00 na 100). Trzeci jest GPT-6.1 Sol (96,83), a najwyżej z modeli Anthropic stoi Claude Fable 5.1 (95,17).
- Najlepszy model otwarty, czyli taki, który można pobrać i uruchomić u siebie, to DeepSeek V4 Pro 0813 z wynikiem 89,83. Ma jednak 1,7 bln parametrów, więc uruchomienie go we własnej firmie wymaga bardzo mocnego sprzętu.
- Bielik 11B v3.0 ma 70,67, czyli tyle, co Mistral Large 2512, model z 675 mld parametrów. Licencja Apache 2.0 pozwala na użytek komercyjny.
- Najlepszy w PLCC wariant PLLuM (69,67) wolno wykorzystywać wyłącznie do badań naukowych. Z komercyjnych wariantów najwyżej stoi Llama-PLLuM-70B-chat-2512 (62,83).
- Globalny test wielojęzyczny MMMLU nie obejmuje polskiego, a trzy z czterech polskich tablic nie mają najnowszych modeli komercyjnych. Ostatnie słowo należy więc do ślepego testu na Waszych tekstach.
Który model AI najlepiej zna język polski?
Według testu PLCC najlepiej znają polski Gemini 3.1 Pro Preview i Gemini 3.8 Flash: oba odpowiedziały poprawnie na 97 proc. pytań. Pierwsza dziesiątka to wyłącznie modele komercyjne Google, OpenAI i Anthropic, a różnica między pierwszym a dziesiątym miejscem wynosi niespełna 2 punkty.
Polish Linguistic and Cultural Competency Benchmark (PLCC) to test Ośrodka Przetwarzania Informacji, czyli państwowego instytutu badawczego, który sprawdza, czy model zna polski język i polską kulturę. Ma 600 ręcznie ułożonych pytań w sześciu kategoriach po 100: historia, geografia, kultura i tradycja, sztuka i rozrywka, gramatyka oraz słownictwo. Pytania sięgają od takich, na które odpowie większość Polaków, po szczegóły regionalne, na przykład o to, czym różni się żurek od barszczu białego.
Model dostaje punkt tylko za odpowiedź w pełni poprawną, bez punktów częściowych, a wynik to odsetek trafień. Wynik 97 oznacza więc 582 dobre odpowiedzi na 600. W tablicy jest 235 modeli z kompletem wyników, a ostatnią aktualizację autorzy zrobili 1 października 2026 r.
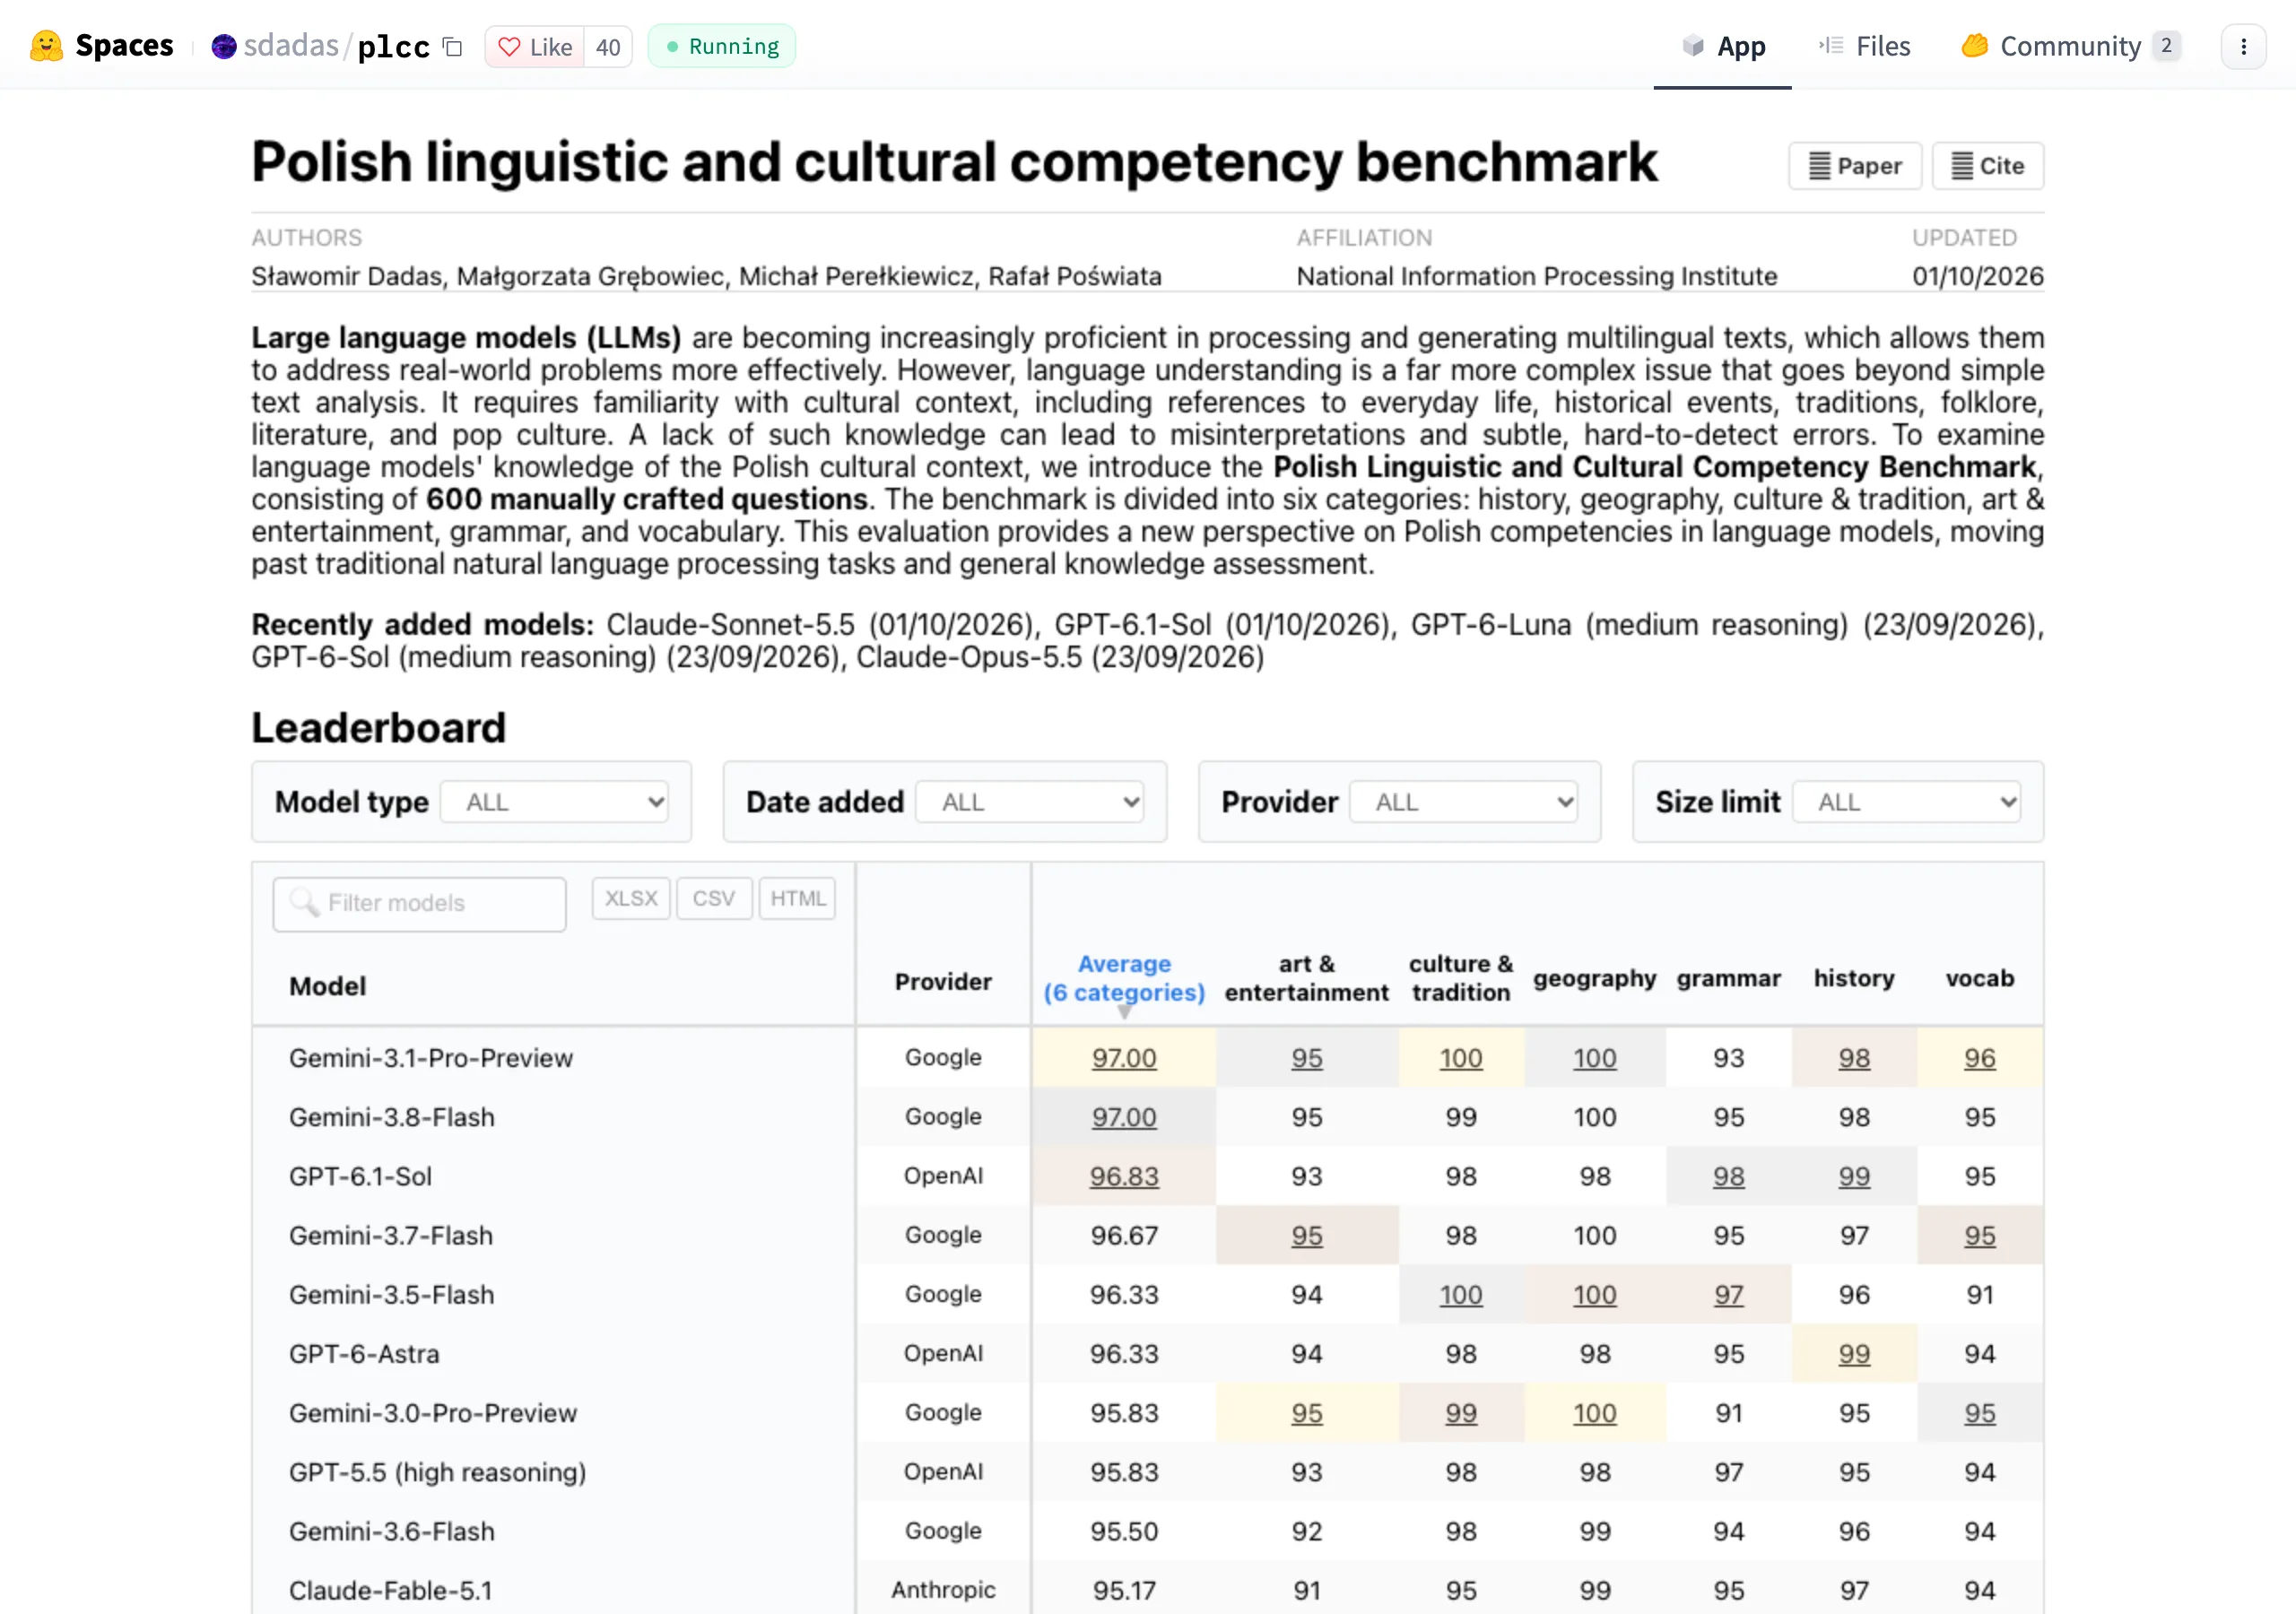
W tabeli zestawiamy czołówkę, najlepszy model otwarty i polskie modele. Obok średniej podajemy dwie kategorie najbliższe pracy biurowej: gramatykę, czyli pytania o zasady pisowni i budowy zdań, oraz słownictwo, czyli znaczenie rzadszych słów, idiomów i przysłów.
| Model | Producent | Średnia PLCC (na 100) | Gramatyka (na 100) | Słownictwo (na 100) |
|---|---|---|---|---|
| Gemini 3.1 Pro Preview | Google, model komercyjny | 97,00 | 93 | 96 |
| Gemini 3.8 Flash | Google, model komercyjny | 97,00 | 95 | 95 |
| GPT-6.1 Sol | OpenAI, model komercyjny | 96,83 | 98 | 95 |
| GPT-6 Astra | OpenAI, model komercyjny | 96,33 | 95 | 94 |
| Claude Fable 5.1 | Anthropic, model komercyjny | 95,17 | 95 | 94 |
| Claude Opus 5.5 | Anthropic, model komercyjny | 92,50 | 94 | 91 |
| DeepSeek V4 Pro 0813 | DeepSeek, model otwarty, 1,7 bln parametrów | 89,83 | 89 | 89 |
| Mistral Large 2512 | Mistral, model otwarty, 675 mld parametrów | 70,67 | 67 | 64 |
| Bielik 11B v3.0 Instruct | SpeakLeash, model otwarty, 11,2 mld parametrów | 70,67 | 57 | 67 |
| PLLuM 12B nc chat 250715 | PLLuM, licencja wyłącznie do badań, 12,2 mld parametrów | 69,67 | 52 | 67 |
| Llama-PLLuM-70B-chat-2512 | PLLuM, licencja Llama 3.1, 70,6 mld parametrów | 62,83 | 55 | 54 |
Największa różnica jest w gramatyce. GPT-6.1 Sol zdobywa w niej 98 punktów, a Bielik 57, więc przy pytaniach o zasady polszczyzny różnica sięga 41 punktów. W średniej Bielik dorównuje za to modelowi Mistral Large, który ma 60 razy więcej parametrów, a wśród modeli do 40 mld parametrów nie ma w PLCC lepszego wyniku.
Jak najprościej sprawdzić, który model lepiej pisze po polsku?
Najprościej dać to samo polskie polecenie kilku modelom w przeglądarce i położyć odpowiedzi obok siebie. Nie trzeba niczego instalować ani płacić, bo czat Bielika i podstawowe plany ChatGPT, Claude i Gemini są bezpłatne.
- Otwórzcie czat Bielika. Na stronie bielik.ai kliknijcie „Korzystaj z Bielika” albo „Porozmawiaj z Bielikiem” w prawym górnym rogu. Oba przyciski prowadzą do czatu chat.bielik.ai. Osobnego konta nie zakładacie, ale zalogować się trzeba: strona logowania SpeakLeash przyjmuje konto Google, LinkedIn, Apple, Facebook, GitHub albo PLGrid.
- W kolejnych kartach otwórzcie ChatGPT, Claude i Gemini. ChatGPT w naszym teście z 5 października 2026 r. odpowiadał nawet bez logowania, Claude wymaga darmowego konta na claude.ai, a Gemini działa z kontem Google na gemini.google.com.
- Wklejcie wszędzie to samo polecenie. Weźcie zadanie z codziennej pracy i usuńcie z niego dane klientów, na przykład: „Odpisz klientowi, który od tygodnia czeka na zwrot pieniędzy za uszkodzony towar. Ton uprzejmy, bez tłumaczenia się, najwyżej 120 słów”.
- Porównajcie odpowiedzi. Szukajcie błędów w odmianie, kalk z angielskiego i sztywnego tonu, a na koniec zadajcie sobie jedno pytanie: którą wersję wysłałbym bez poprawek?
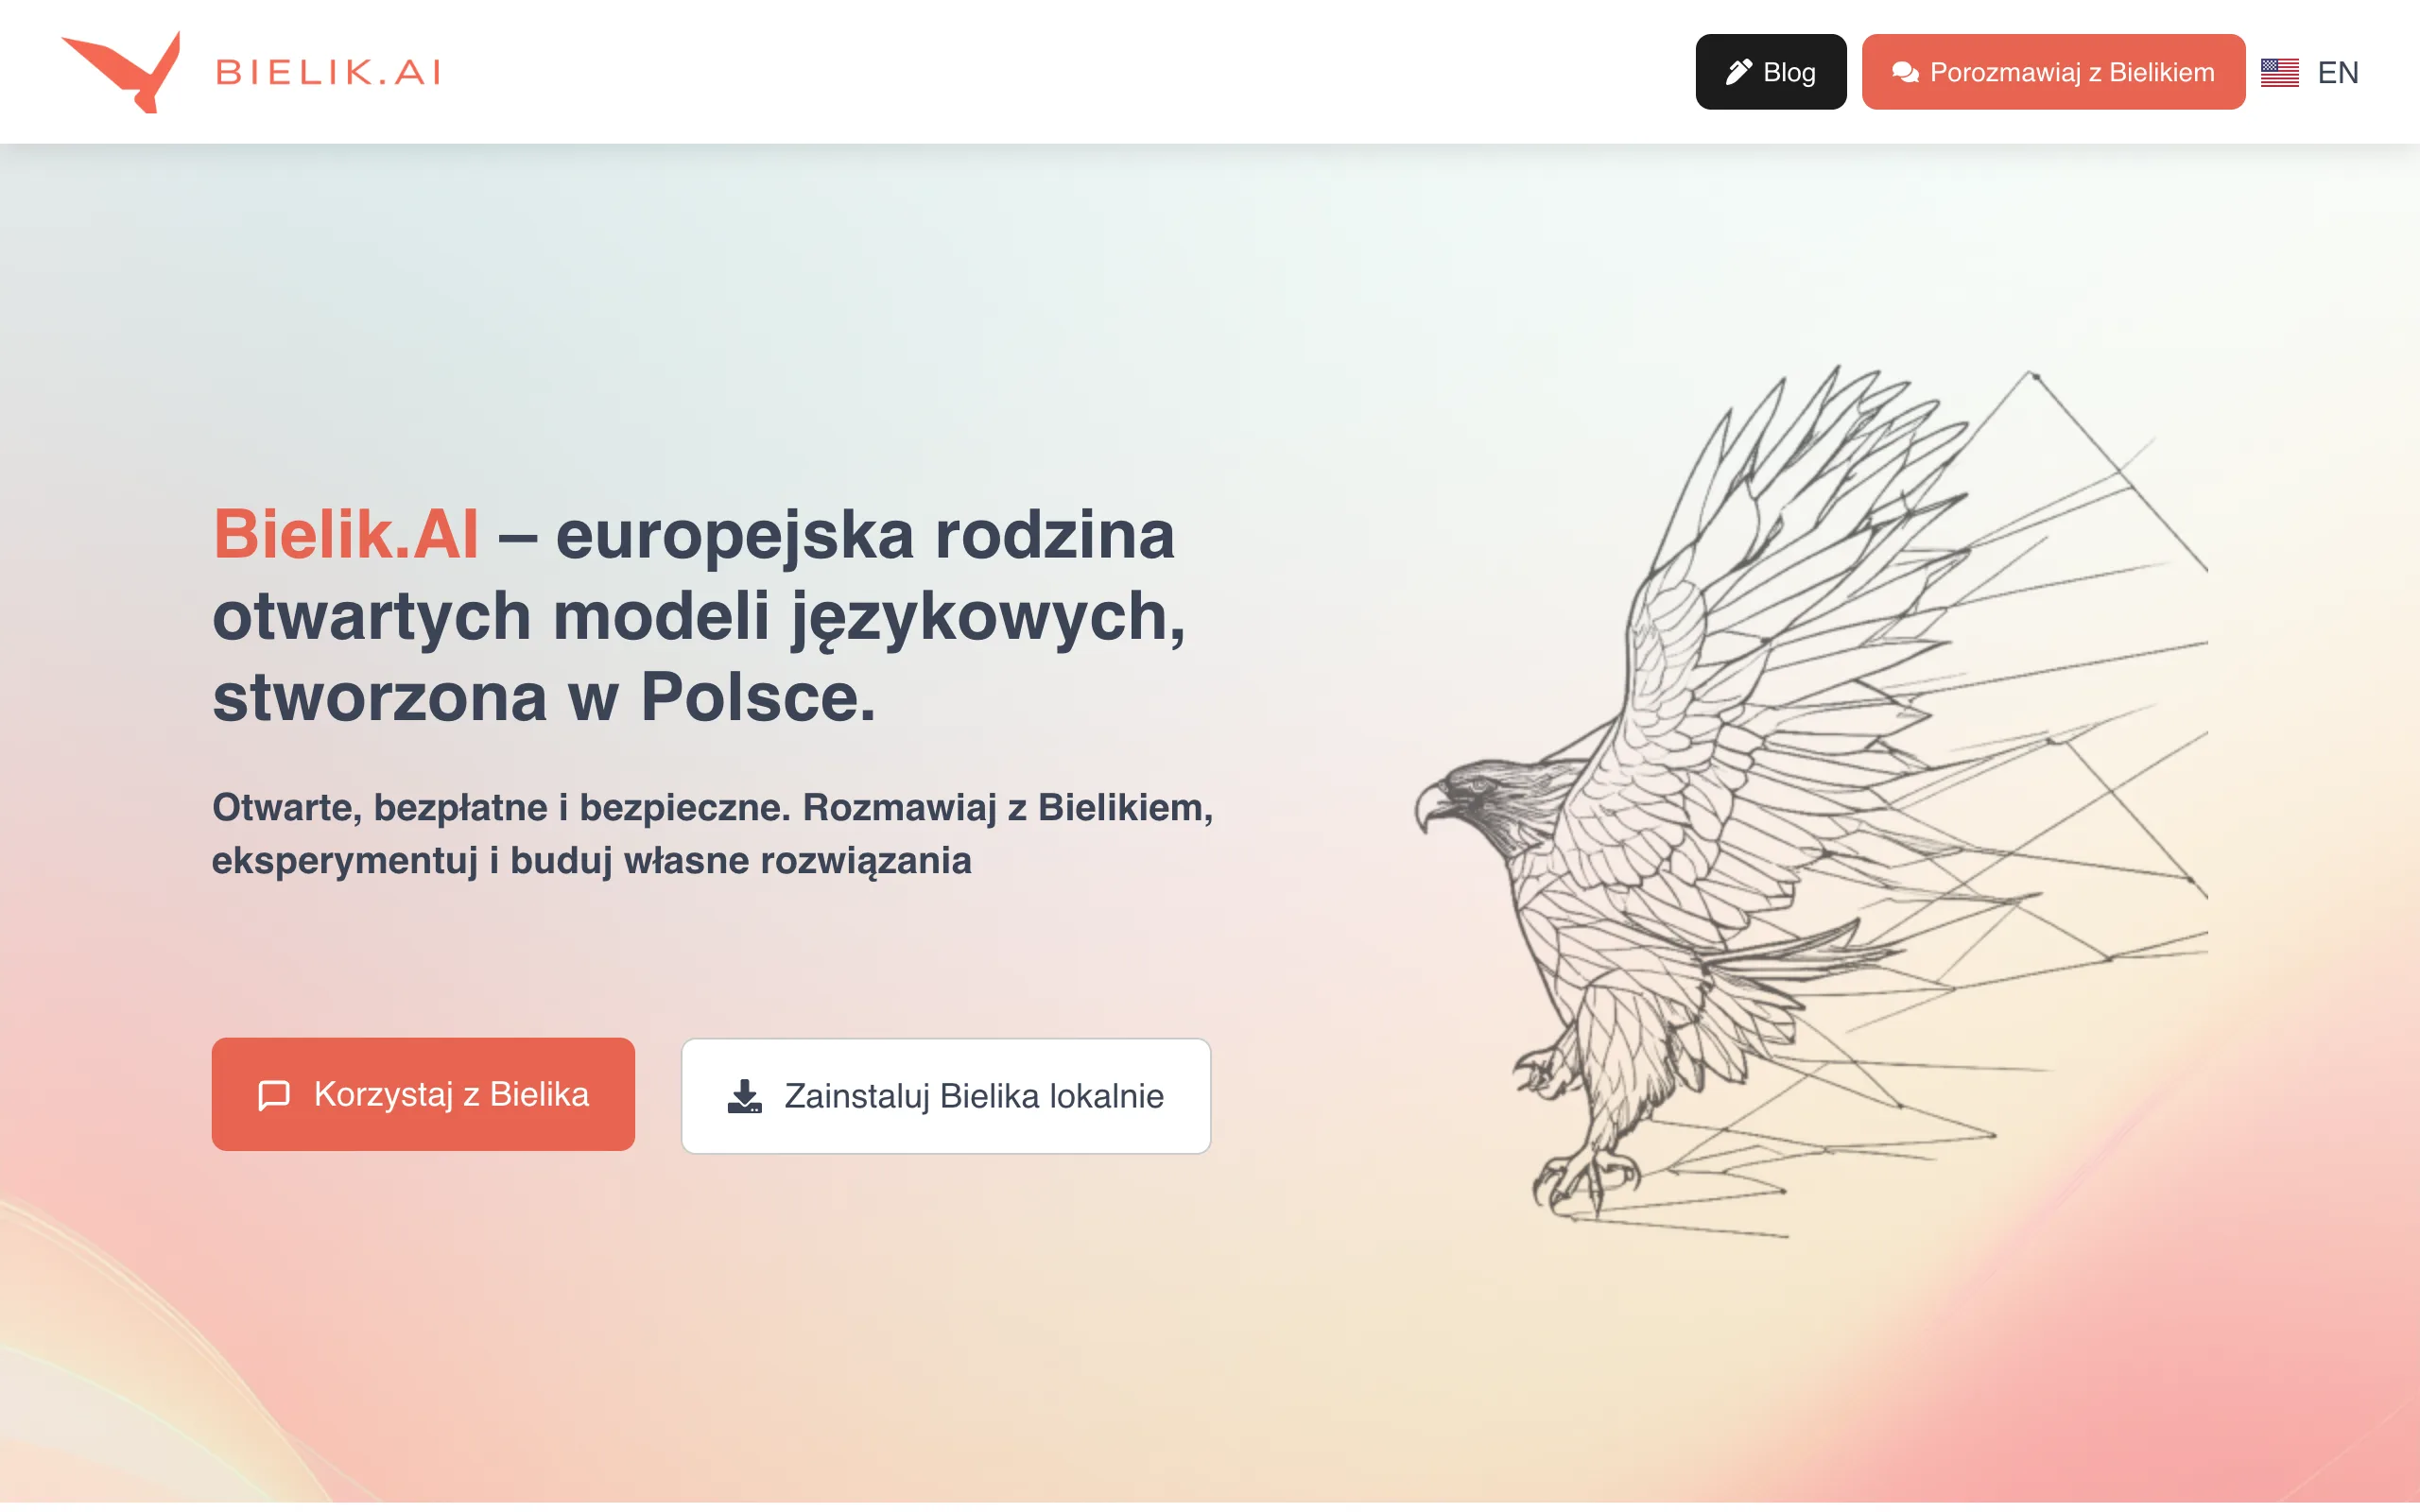
Takie porównanie daje pierwsze wrażenie, a nie werdykt. Jedno polecenie to za mało, żeby wybrać model dla całej firmy, a w każdym czacie warto sprawdzić, jaki model akurat odpowiada, bo wyniki w tabeli PLCC dotyczą konkretnych wersji. Do darmowych planów nie wklejajcie też danych firmy: na prywatnych kontach ChatGPT i Claude o tym, czy producent trenuje modele na rozmowach, decyduje ustawienie użytkownika, co opisujemy w porównaniu Claude czy ChatGPT dla firmy. Gdy pierwsze wrażenie zawęzi wybór, rozstrzygnijcie go ślepym testem na 20 zadaniach.
Dlaczego globalne rankingi nie mówią, jak model radzi sobie po polsku?
Globalne rankingi najczęściej w ogóle nie sprawdzają polskiego. Gdy producenci pokazują, jak ich modele działają w innych językach, sięgają często po MMMLU, czyli angielski test wiedzy MMLU przetłumaczony przez zawodowych tłumaczy na 14 języków. Wśród nich są niemiecki, hiszpański, suahili i joruba, ale nie ma polskiego.
Widać to w dokumentacji Anthropic: tabela wyników Claude w innych językach obejmuje tylko te 14 języków, a producent sam dopisuje, żeby testować model w językach ważnych dla własnych zastosowań. Ogólne rankingi modeli opisujemy w artykule Ranking AI 2026: najlepsze modele według oficjalnych testów. Pokazują one, który model najlepiej rozumuje albo programuje, ale nie mówią, czy napisze poprawnego maila do polskiego klienta.
Dlatego polska firma potrzebuje dwóch źródeł: polskich benchmarków, które zawężają wybór do kilku modeli, i własnego testu, który rozstrzyga między nimi.
Jak wypadają Bielik i PLLuM w polskich testach?
W żadnej z czterech polskich tablic z oficjalnymi wynikami polski model nie zajmuje pierwszego miejsca, ale w każdej jest blisko modeli wielokrotnie większych od siebie.
Bielik to rodzina otwartych polskich modeli językowych, którą rozwijają fundacja SpeakLeash i społeczność Bielika razem z ACK Cyfronet AGH. Najnowszy model z kompletem wyników, Bielik 11B v3.0 Instruct, trenowano na tekstach w 32 językach europejskich z naciskiem na polski. Ma licencję Apache 2.0, a wypróbować go można w czacie na stronie chat.bielik.ai po zalogowaniu się kontem Google, LinkedIn albo GitHub.
PLLuM to rodzina polskich modeli językowych, którą finansuje Minister Cyfryzacji, a koordynuje NASK. Od 2025 r. rozwija ją sojusz HIVE AI, złożony z instytucji naukowych i organizacji świadczących cyfrowe usługi publiczne, z myślą o polskiej administracji. Czat z PLLuM udostępnia CLARIN-PL pod adresem pllum.clarin-pl.eu.
Tabela pokazuje najlepszy wynik każdej z rodzin w czterech testach i lidera danej tablicy. Testy mają różne skale, więc wyniki porównujemy tylko w obrębie jednego wiersza.
| Test i skala | Najlepszy Bielik | Najlepszy PLLuM | Lider tablicy |
|---|---|---|---|
| PLCC, odsetek poprawnych odpowiedzi (na 100) | Bielik-11B-v3.0-Instruct: 70,67. Przed nim jest 108 z 235 modeli. | PLLuM-12B-nc-chat-250715: 69,67 (licencja badawcza). Najlepszy komercyjny: Llama-PLLuM-70B-chat-2512, 62,83. | Gemini-3.1-Pro-Preview i Gemini-3.8-Flash: 97,00. |
| Open PL LLM Leaderboard, średnia znormalizowana, wariant 5-shot | Bielik-11B-v3.0-Instruct: 65,93, 14. miejsce. | Brak pełnego wyniku: wpisy PLLuM są oznaczone jako niepełne. | Mistral-Large-Instruct-2411: 69,84. |
| CPTUB, skala od 0 do 5 | Bielik-11B-v3.0-Instruct: 3,73, 34. miejsce na 102. | pllum-12b-nc-chat-250715: 3,67 (licencja badawcza). | Muse-Glimmer-30B w trybie rozumowania: 4,42. |
| LLMzSzŁ, trafność na pytaniach egzaminacyjnych (w proc.) | Bielik-11B-v2.6-Instruct: 59,23. Bielika 11B v3.0 w tablicy nie ma. | Llama-PLLuM-70B-base: 64,56, 8. miejsce na 99. | Qwen2.5-72B-Instruct: 69,06. |
Z tabeli wynikają dwie rzeczy. Po pierwsze, Bielik z 11 mld parametrów trzyma się zwykle kilka punktów za modelami, które mają ich 70 mld i więcej. Po drugie, licencje: najlepiej wypadające warianty PLLuM mają w nazwie „nc”, a ich licencja (PLLuM 1.1) pozwala na korzystanie z nich wyłącznie w celach badań naukowych i wprost wyklucza osiąganie korzyści majątkowej. Firma, która chce użyć PLLuM, musi więc sięgnąć po warianty z licencją Apache 2.0 albo Llama 3.1.
W Open PL LLM Leaderboard widać jeszcze jedną ważną dla firm rzecz. Bielik 11B v3.0 w wersji skompresowanej do 4 bitów (plik Q4_K_M w formacie GGUF), która zajmuje mniej pamięci, uzyskał 65,91, czyli niemal tyle samo, co pełna wersja z wynikiem 65,93.
Chcecie wiedzieć, który model napisze Wasze maile najlepiej?
Na warsztacie Podstawy AI zespół pracuje na ChatGPT, Claude i Gemini, na Waszych zadaniach i Waszych tekstach. Przed szkoleniem robimy audyt procesów. 1 lub 2 dni, stacjonarnie albo online, do 15 osób.
Jakie są polskie benchmarki i co mierzy każdy z nich?
Polskie benchmarki z oficjalnymi tablicami wyników są cztery: PLCC, Open PL LLM Leaderboard, CPTUB i LLMzSzŁ. Każdy mierzy co innego, dlatego jeden model może być wysoko w jednej tablicy i nisko w drugiej.
| Test | Kto prowadzi | Co sprawdza | Czy są tam najnowsze modele komercyjne |
|---|---|---|---|
| PLCC | Ośrodek Przetwarzania Informacji, państwowy instytut badawczy. | 600 pytań o polską historię, geografię, kulturę, sztukę, gramatykę i słownictwo. | Tak. Ostatnia aktualizacja: 1.10.2026. |
| Open PL LLM Leaderboard | SpeakLeash. | Kilkanaście zadań na polskich tekstach, m.in. odpowiadanie na pytania na podstawie podanego dokumentu. | Nie. Tablica obejmuje modele otwarte. |
| CPTUB (Complex Polish Text Understanding Benchmark) | SpeakLeash. | Rozumienie trudnych tekstów: znaczeń ukrytych, sarkazmu, związków frazeologicznych i podchwytliwych pytań. | Częściowo. Z modeli komercyjnych są tylko Gemini 2.0 Flash i Flash Lite. |
| LLMzSzŁ (LLM-y za Szkolną Ławą) | Centrum Sztucznej Inteligencji UAM w Poznaniu. | Prawie 19 tys. zamkniętych pytań z polskich egzaminów państwowych z 154 dziedzin. | Nie. Tablica obejmuje modele otwarte. |
Dla firmy piszącej maile i umowy najwięcej mówią PLCC, bo sprawdza język i kontekst kulturowy, oraz CPTUB, bo sprawdza, czy model wyczuje sarkazm albo idiom w wiadomości od klienta. LLMzSzŁ mierzy raczej wiedzę szkolną i zawodową. Open PL LLM Leaderboard pokazuje, który model otwarty najlepiej wykonuje typowe zadania na polskich tekstach.
SpeakLeash prowadzi też Polish MT-Bench, który ocenia rozmowę w kilku turach, i Polish EQ-Bench, który mierzy inteligencję emocjonalną modelu. W dniu odczytu obie strony były wstrzymane i nie wyświetlały wyników, więc ich nie cytujemy.
Dlaczego w polskich tablicach brakuje najnowszych modeli?
Z czterech tablic tylko PLCC dopisuje nowe modele komercyjne na bieżąco: Claude Sonnet 5.5 i GPT-6.1 Sol trafiły tam 1 października 2026 r. W Open PL LLM Leaderboard i LLMzSzŁ nie ma żadnego modelu GPT, Claude ani Gemini, a w CPTUB jest tylko Gemini 2.0 Flash i jego wersja Lite.
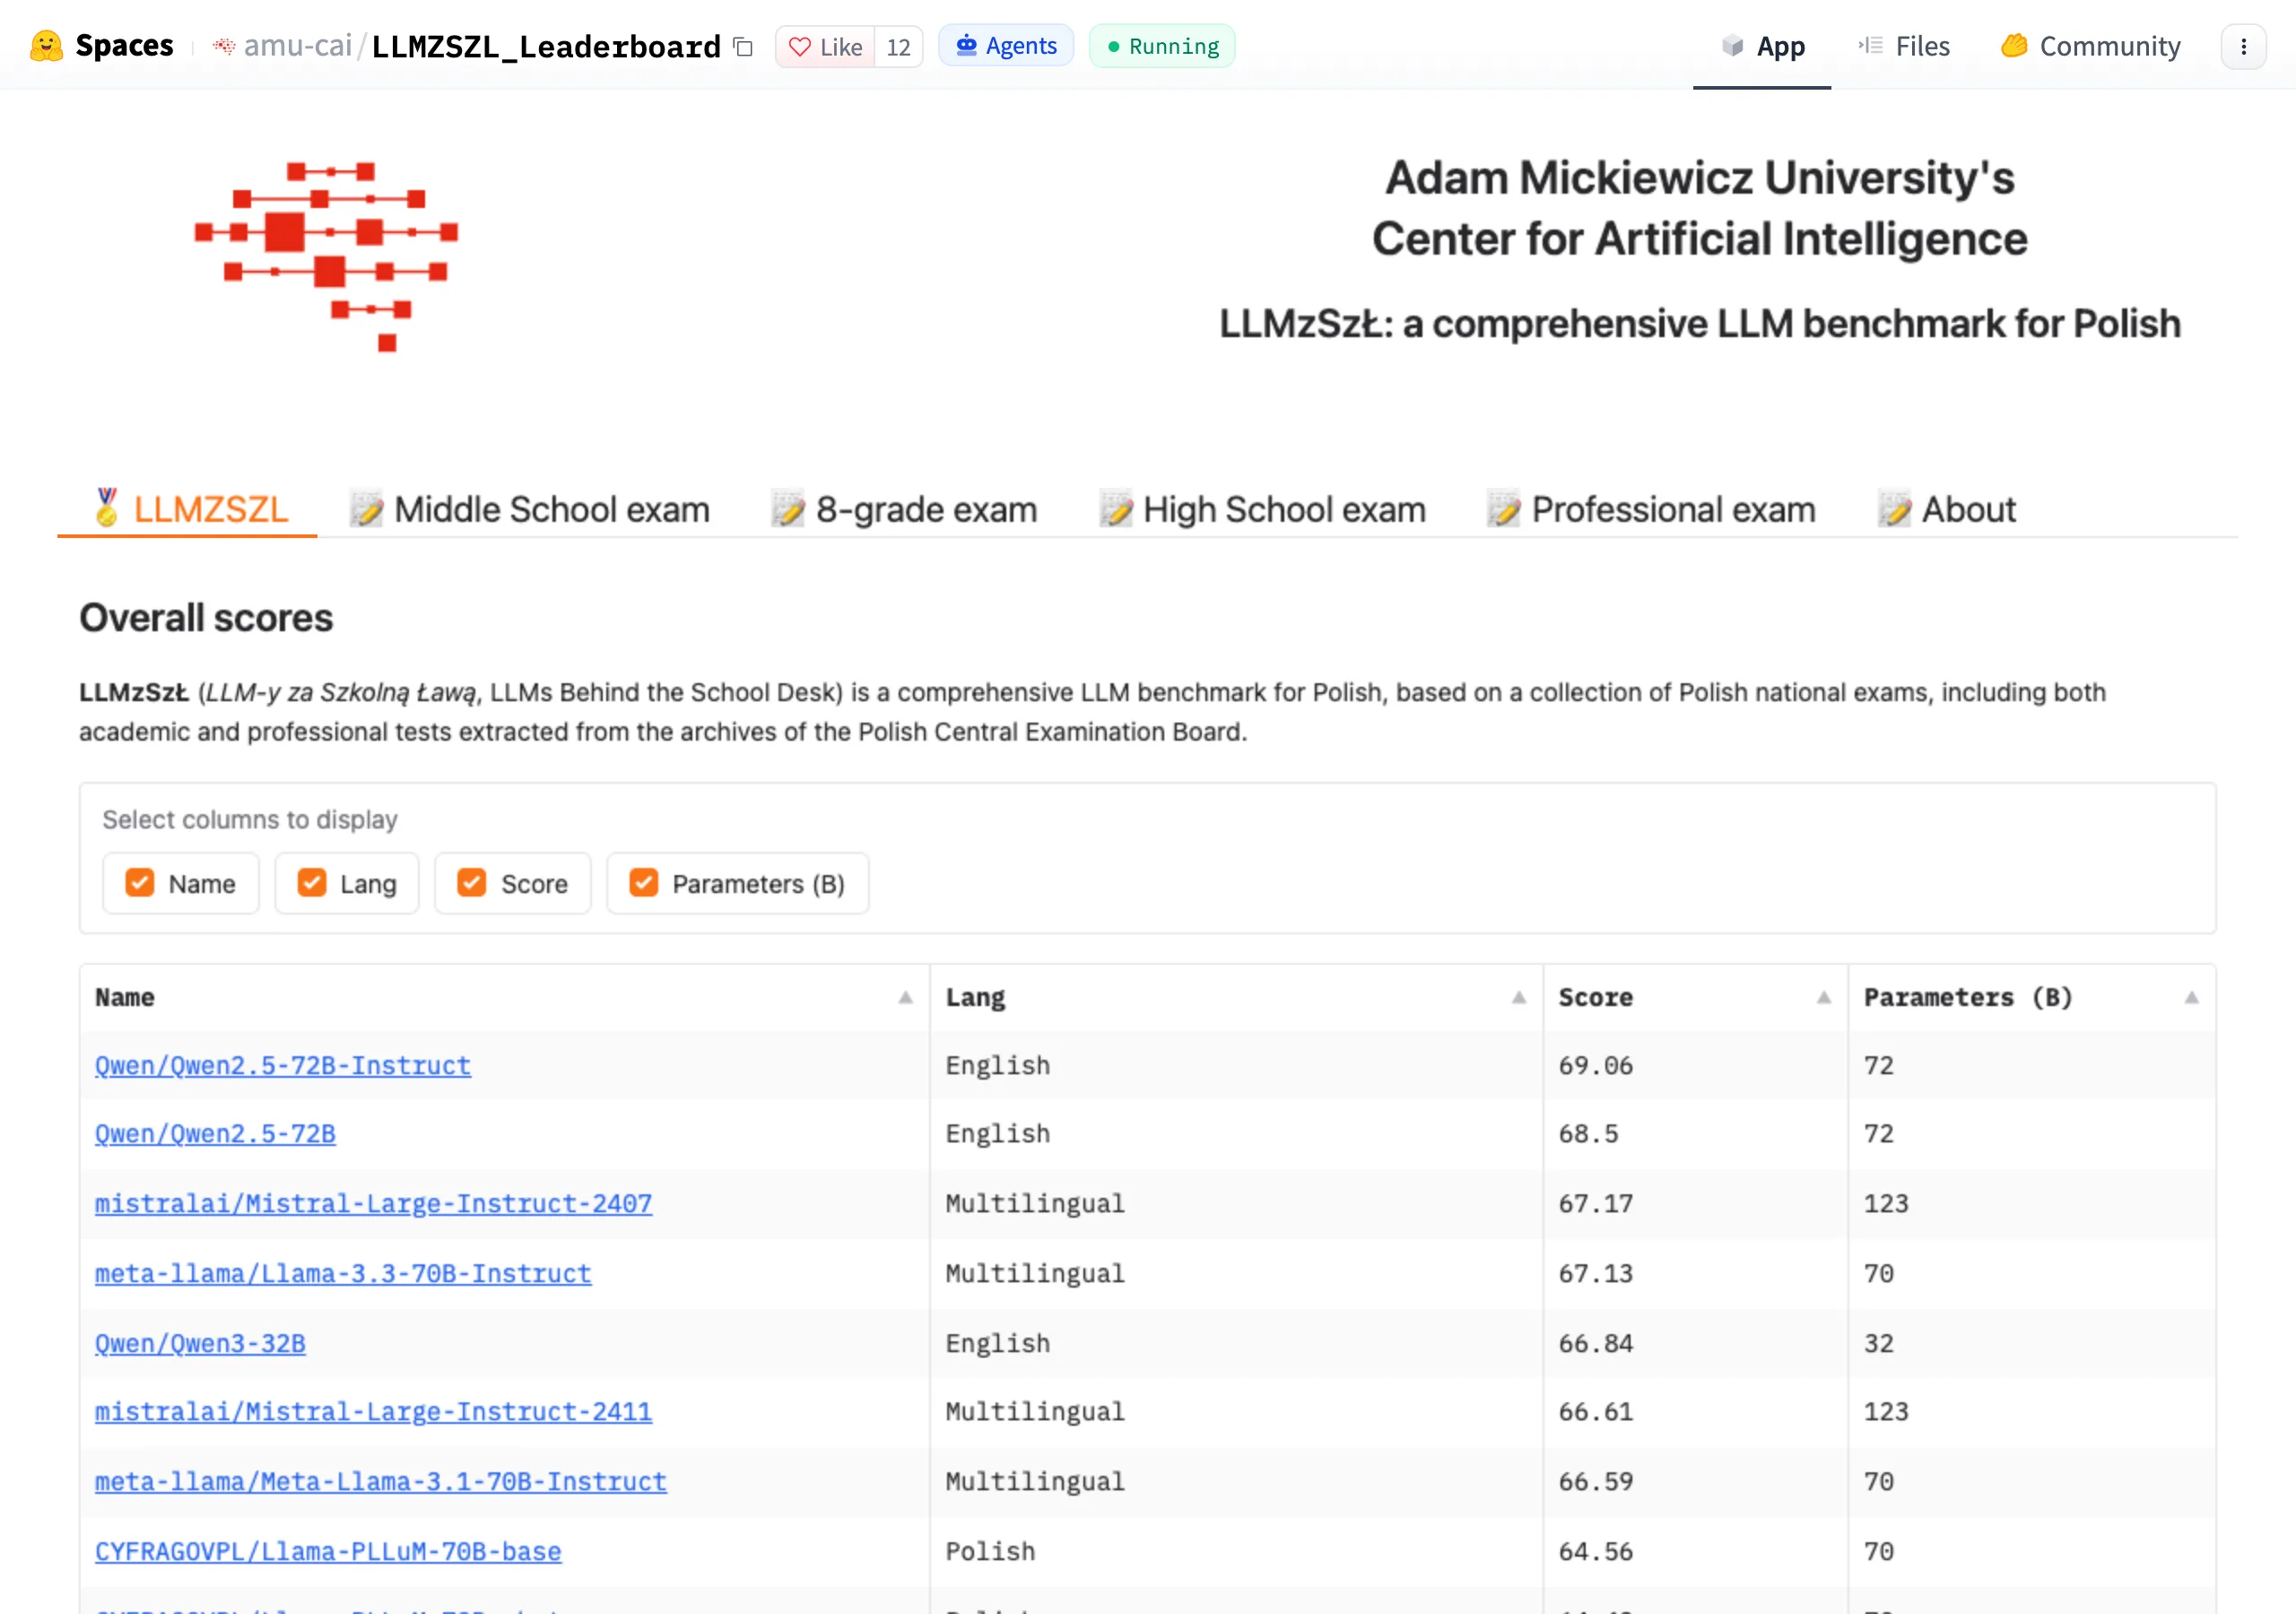
Autorzy tablic nie podają powodów, ale z naszej perspektywy są one praktyczne. Te testy prowadzą naukowcy i wolontariusze, na przykład w polskiej infrastrukturze superkomputerowej PLGrid, gdzie model otwarty uruchamia się bez opłat za zapytania. Model komercyjny dostępny jest tylko przez płatne API, czyli usługę, w której płaci się za każde zapytanie, więc tysiące pytań razy kilkadziesiąt modeli to realny rachunek. Część zadań w Open PL LLM Leaderboard sprawdza też, jakie prawdopodobieństwo model przypisuje każdej możliwej odpowiedzi, a do tego potrzebny jest dostęp do samego modelu, którego płatne API nie daje.
Dochodzi opóźnienie. Model trafia do tablicy dopiero wtedy, gdy jest ogólnie dostępny. Gemini 4 Argon, którego Google zapowiedziało 30 września 2026 r., na razie trafił tylko do wybranej grupy specjalistów od cyberbezpieczeństwa, więc wyniku w polskich testach jeszcze nie ma. Takie modele dopisujemy przy comiesięcznej aktualizacji, gdy dostaną oficjalny wynik.
Bielik, PLLuM czy model globalny: co wybrać do pracy na polskich tekstach?
Jeśli liczy się najwyższa jakość tekstu, a dane mogą trafić do chmury dostawcy na warunkach planu firmowego, wybierzcie model globalny z czołówki PLCC. Jeśli danych nie wolno wysłać poza firmę, przetestujcie Bielika albo komercyjny wariant PLLuM, uruchomione na własnym serwerze.
Poniżej zestawiamy cztery typowe sytuacje. W każdej podajemy, co sprawdzić najpierw i dlaczego.
| Sytuacja w firmie | Od czego zacząć test | Dlaczego |
|---|---|---|
| Maile i odpowiedzi do klientów, w których liczą się styl i poprawność. | Model globalny z czołówki PLCC, np. Gemini, GPT albo Claude. | W gramatyce i słownictwie czołówka wyprzedza polskie modele o kilkadziesiąt punktów. |
| Umowy, dane osobowe i tajemnica przedsiębiorstwa, których nie wolno wysyłać na zewnątrz. | Bielik 11B v3.0 albo PLLuM z licencją Apache 2.0 lub Llama 3.1, na własnym serwerze. | Dane zostają w firmie, a licencja pozwala na użytek komercyjny. |
| Tysiące powtarzalnych zadań, np. sortowanie zgłoszeń albo streszczenia. | Mały model otwarty uruchomiony lokalnie. | Koszt to sprzęt i jego utrzymanie, bez opłat za każde zapytanie. Wersja skompresowana Bielika traci w teście niecałe 0,1 punktu. |
| Urząd albo firma pracująca na języku urzędowym. | PLLuM w wariancie z licencją komercyjną. | Twórcy projektują go pod czatboty na stronach urzędów, asystentów urzędników i wyszukiwanie w dokumentach. |
Darmowa licencja nie oznacza darmowego wdrożenia. Model otwarty trzeba uruchomić na własnym sprzęcie: twórcy PLLuM podają, że wymaga to od 24 do 168 GB pamięci kart graficznych, zależnie od komponentu. Do tego dochodzi ktoś, kto taki serwer utrzyma.
Przy modelu globalnym sprawdźcie z kolei, gdzie dostawca przechowuje dane i czy trenuje na nich modele. Różnice między planami firmowymi opisujemy w porównaniu Claude czy ChatGPT: który model wybrać dla firmy. Jeśli model ma wpływać na decyzje o klientach albo pracownikach, sprawdźcie też obowiązki z rozporządzenia o sztucznej inteligencji, które zbieramy na stronie AI Act dla firm.
Jak przetestować modele AI na własnych polskich tekstach?
Najpewniej rozstrzygnie to ślepy test, w którym osoba oceniająca nie wie, który model napisał daną odpowiedź. Wystarczy pięć kroków.
- Zbierzcie 20 prawdziwych zadań z jednego procesu. Na przykład 10 maili od klientów, na które trzeba odpowiedzieć, 5 umów do streszczenia i 5 reklamacji do sklasyfikowania. Przed testem usuńcie z nich dane osobowe.
- Wybierzcie trzy modele. Jeden z czołówki PLCC, jeden tańszy i jeden otwarty, np. Bielika, jeśli rozważacie własny serwer.
- Dajcie każdemu modelowi to samo polecenie i te same pliki. Zapiszcie odpowiedzi w arkuszu, a obok czas do gotowego wyniku.
- Oceńcie odpowiedzi na ślepo. Osoba trzecia miesza odpowiedzi i usuwa nazwy modeli. Oceniać powinien ktoś, kto na co dzień pisze te teksty: poprawność językową, zgodność z faktami i to, czy wysłałby odpowiedź bez poprawek.
- Policzcie wynik i dopiszcie koszt. Dla każdego modelu podajcie odsetek odpowiedzi gotowych do wysłania i miesięczny koszt dla Waszego zespołu. Wybierzcie model, który daje najwięcej gotowych tekstów za rozsądne pieniądze.
Co to znaczy dla Twojej firmy?
- Wybór modelu. Polskie benchmarki zawężają wybór do kilku modeli, ale nie wskażą zwycięzcy dla Waszych maili i umów. Do tego potrzebny jest ślepy test na Waszych tekstach.
- Dane i licencje. Zanim wybierzecie model polski, sprawdźcie licencję konkretnego wariantu. Najlepsze w testach warianty PLLuM są tylko do badań naukowych.
- Aktualność. Czołówka się zmienia: GPT-6.1 Sol, dopisany do PLCC 1 października 2026 r., od razu zajął trzecie miejsce, a od 23 września tablica urosła o osiem modeli. Decyzję warto sprawdzać raz na kwartał na tym samym zestawie testowym.
- Umiejętności zespołu. Nawet najlepszy model nie poprawi maila, jeśli pracownik nie umie napisać polecenia i sprawdzić wyniku. Bez tego test pokaże umiejętności osób testujących, a nie możliwości modeli.
Ostatnią rzecz możemy wziąć na siebie. Na warsztacie Podstawy AI zespół uczy się pracy na ChatGPT, Claude i Gemini na własnych zadaniach. Warsztat prowadzi Adrian Skobiej, a po nim robimy follow-up i sprawdzamy, co realnie weszło do codziennej pracy.
Zanim kupicie licencje dla całej firmy
Zróbcie warsztat, na którym zespół sprawdzi modele na swoich polskich tekstach: mailach, umowach i odpowiedziach do klientów. Wyjdziecie z porównaniem zrobionym na Waszej pracy i z ludźmi, którzy umieją z AI korzystać.
Najczęstsze pytania
Stan na 5 października 2026 r.: w polskim teście PLCC, który sprawdza znajomość polskiego języka i kultury, prowadzą Gemini 3.1 Pro Preview i Gemini 3.8 Flash firmy Google, oba z wynikiem 97,00 na 100. Trzeci jest GPT-6.1 Sol od OpenAI z wynikiem 96,83, a najwyżej z modeli Anthropic stoi Claude Fable 5.1 z wynikiem 95,17. Różnice w czołówce są małe, więc o wyborze dla firmy powinien zdecydować test na jej własnych tekstach.
W ogólnej znajomości polszczyzny nie. W teście PLCC Bielik 11B v3.0 ma 70,67 punktu, a GPT-6.1 Sol 96,83. Bielik ma jednak dwie przewagi, których ChatGPT nie daje: firma może go pobrać i uruchomić na własnym serwerze, a licencja Apache 2.0 pozwala na użytek komercyjny bez opłat licencyjnych. Wśród modeli do 40 mld parametrów Bielik ma w PLCC najlepszy wynik.
Bielika rozwijają fundacja SpeakLeash i społeczność Bielika razem z ACK Cyfronet AGH, a wszystkie jego modele mają licencję Apache 2.0. PLLuM finansuje Minister Cyfryzacji, a koordynuje NASK; rodzinę rozwijają polskie instytucje naukowe głównie z myślą o administracji publicznej. Część modeli PLLuM ma licencję komercyjną (Apache 2.0 albo licencję Llama 3.1), ale warianty z oznaczeniem „nc” wolno wykorzystywać wyłącznie do badań naukowych.
Bielik tak: licencja Apache 2.0 pozwala na użytek komercyjny. PLLuM częściowo: modele z serii 2512 mają licencję Apache 2.0 albo licencję Llama 3.1, ale warianty „nc” są tylko do badań. Darmowa licencja nie oznacza darmowego wdrożenia, bo model trzeba uruchomić na własnym sprzęcie. Twórcy PLLuM podają, że wymaga to od 24 do 168 GB pamięci kart graficznych, zależnie od komponentu.
Z czterech polskich tablic z oficjalnymi wynikami tylko PLCC regularnie testuje najnowsze modele komercyjne; ostatnio zaktualizowano ją 1 października 2026 r. Open PL LLM Leaderboard i LLMzSzŁ obejmują wyłącznie modele otwarte, a CPTUB z modeli komercyjnych ma tylko Gemini 2.0 Flash i Flash Lite. Testy prowadzą naukowcy i wolontariusze, a każde zapytanie do płatnego modelu kosztuje. Nowy model trafia też do tablicy dopiero wtedy, gdy jest ogólnie dostępny.
Co miesiąc. Przy każdej aktualizacji odczytujemy na nowo oficjalne tablice wyników, zmieniamy datę stanu na górze artykułu i dopisujemy modele, które w tym czasie dostały oficjalny wynik. Nie dopisujemy modeli na podstawie zapowiedzi producentów ani wyników z blogów.