To materiał edukacyjny i nie jest poradą prawną. Opisuję praktykę wdrożeniową, a ocenę konkretnej sytuacji w firmie zostawiam inspektorowi ochrony danych albo prawnikowi. Warunki planów i umów sprawdziłem na oficjalnych stronach OpenAI, Anthropic, Google i Microsoftu. Dostawcy zmieniają je często, więc stan opisu to październik 2026.
W skrócie
- RODO ocenia przetwarzanie danych, więc liczy się sposób korzystania z czatu. Za dane wklejone przez pracownika odpowiada firma jako administrator, czyli podmiot, który decyduje o celach i sposobach przetwarzania.
- Konto prywatne (ChatGPT Free, Go, Plus, Pro, Claude Free, Pro, Max) nie daje firmie umowy powierzenia, a o tym, czy rozmowy trafią do trenowania modeli, decydują ustawienia pracownika.
- Plan firmowy (ChatGPT Business i Enterprise, Claude Team i Enterprise, Gemini w Google Workspace, Microsoft Copilot Chat dla organizacji) pozwala zawrzeć umowę powierzenia i ma domyślnie wyłączone trenowanie.
- Danych osobowych, umów i tajemnic firmy nie wkleja się do konta prywatnego. W planie firmowym decydują zasady zapisane w polityce AI.
- Najprostsza ochrona to anonimizacja przed wklejeniem: zamiana nazwisk na role i usunięcie numerów, adresów i maili.
- Pierwszy krok jutro rano nie wymaga budżetu ani prawnika: jedna reguła o danych osobowych wysłana zespołowi, wyłączenie trenowania na prywatnych kontach, sprawdzenie umowy powierzenia w narzędziu, które już macie, i lista pytań UODO wypełniona dla jednego zastosowania. Lista kroków na jutro.
Czy ChatGPT jest zgodny z RODO?
O zgodności ChatGPT z RODO decyduje sposób korzystania z niego, bo RODO, czyli unijne rozporządzenie o ochronie danych osobowych, ocenia przetwarzanie danych. Zgodne albo niezgodne jest to, co firma i jej pracownicy robią z danymi w narzędziu AI.
Firma, która decyduje, po co i jak przetwarza dane klientów, jest ich administratorem (art. 4 pkt 7 RODO). Musi więc mieć podstawę prawną z art. 6, czyli na przykład umowę z klientem albo uzasadniony interes, i trzymać się zasad z art. 5. Przy czatach AI najczęściej w grę wchodzą dwie z nich: minimalizacja, która każe przetwarzać tylko dane niezbędne do celu, i ograniczenie przechowywania, które każe trzymać je nie dłużej, niż trzeba. W praktyce pytanie z tytułu sprowadza się do tego, czy firma panuje nad tym, gdzie dane trafiają i co się z nimi dzieje.
Z tym jest dziś kłopot. Urząd Ochrony Danych Osobowych (UODO) w komunikacie z 6 sierpnia 2026 roku przytacza badanie Społecznego Zespołu Ekspertów przy Prezesie UODO: 95,9% organizacji nie uważa się za przygotowane do wdrożenia AI zgodnie z RODO, a od 41 do 58,5% nie dostrzega związku między narzędziami AI a przetwarzaniem danych osobowych. Urząd zauważa też, że pytanie o zgodność pada zwykle dopiero wtedy, gdy narzędzie już działa. Te same zasady dotyczą Claude, Gemini i Copilota, więc wszystko poniżej odnosi się do każdego czatu AI.
Czym różni się prywatne konto ChatGPT od planu firmowego?
Prywatne konto działa na warunkach, które zaakceptował sam pracownik, a plan firmowy na umowie między firmą a dostawcą. Od tej różnicy zależy pięć rzeczy: trenowanie modeli, umowa powierzenia, czas przechowywania danych, dostęp administratora i miejsce, w którym dane leżą.
Pierwszą z tych różnic widać na ekranie startowym. ChatGPT otwarty na chatgpt.com bez logowania pokazuje pod polem do wpisywania szarą stopkę: korzystając z czatu, zgadzasz się na warunki OpenAI, a czaty mogą być przeglądane i wykorzystywane do ulepszania modeli. W naszym teście z Polski 5 października 2026 roku czat działał bez konta, choć pomoc OpenAI wciąż pisze, że w Europie poza Wielką Brytanią ta funkcja jeszcze nie działa. Jeśli zobaczysz prośbę o logowanie, to samo dotyczy darmowego konta.
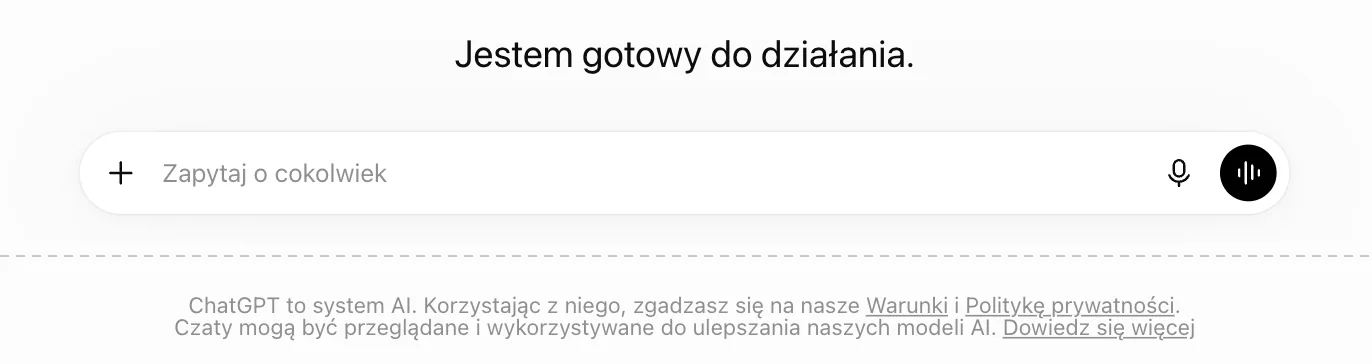
Jeśli handlowiec wklei tu maila od klienta, dane trafią do OpenAI na warunkach, które zaakceptował sam, a firma jako administrator nie ma z dostawcą żadnej umowy i nawet nie wie o tej rozmowie. Według pomocy OpenAI także bez logowania da się w ustawieniach wyłączyć trenowanie, a wybór zapisuje się w tej przeglądarce. Umowy powierzenia to jednak nie zastępuje.
Tabela zestawia te pięć rzeczy dla ChatGPT i Claude. Gemini i Copilota omawiam pod nią.
| Co sprawdzasz | Konto prywatne | Plan firmowy |
|---|---|---|
| Trenowanie modeli na rozmowach | OpenAI może używać rozmów do trenowania, dopóki pracownik tego nie wyłączy, a w Claude decyduje o tym przełącznik „Help improve our AI models” w ustawieniach prywatności. | Domyślnie wyłączone w ChatGPT Business i Enterprise oraz w Claude Team i Enterprise. |
| Umowa powierzenia (art. 28 RODO) | Nie ma jej, bo z dostawcą umowę zawarł pracownik jako osoba prywatna. | OpenAI podpisuje ją na wniosek dla Business, Enterprise i API, a u Anthropic jest automatycznie częścią warunków komercyjnych. |
| Czas przechowywania | Decyduje pracownik. W Claude przy zgodzie na trenowanie dane mogą zostać do 5 lat w formie pozbawionej identyfikacji. | W ChatGPT Business i Enterprise czas ustawia administrator, a usunięte rozmowy znikają z systemów OpenAI w ciągu 30 dni. |
| Kto widzi rozmowy w firmie | Nikt poza pracownikiem, więc firma nie wie, co wyszło na zewnątrz. | W ChatGPT Business administrator przestrzeni roboczej może przeglądać, eksportować i usuwać rozmowy użytkowników. |
| Gdzie leżą dane | Na serwerach dostawcy, bez wyboru regionu. | OpenAI daje przechowywanie w Europie w ChatGPT Enterprise, Edu i API. W Business wybór regionu jest wdrażany stopniowo (stan na wrzesień 2026), a kopia poleceń trafia na krótko do USA na potrzeby wykrywania nadużyć. Anthropic przechowuje dane w USA. |
Z tabeli wynika, że o bezpieczeństwie danych decyduje przede wszystkim umowa. Pracownik może wyłączyć trenowanie na prywatnym koncie, ale nie podpisze w imieniu firmy umowy powierzenia, a bez niej firma przekazuje dane dostawcy, nad którym nie ma kontroli.
Czy wyłączenie trenowania albo czat tymczasowy wystarczą?
Nie wystarczą, choć zmniejszają ryzyko. Według dokumentacji OpenAI po wyłączeniu opcji „Improve the model for everyone” nowe rozmowy nie trafiają do treningu. Wyjątkiem są oceny: jeśli pracownik oceni odpowiedź kciukiem w górę albo w dół, cała rozmowa z tą oceną może posłużyć do trenowania, nawet po wyłączeniu opcji. Anthropic stosuje podobną zasadę do opinii przesłanych kciukiem, także w planach firmowych.
Czat tymczasowy w ChatGPT nie trafia do historii i nie jest używany do treningu, ale OpenAI może przechowywać jego kopię do 30 dni ze względów bezpieczeństwa. Na prywatnym koncie to nadal przekazanie danych dostawcy bez umowy powierzenia.
Claude a RODO: czym się różni od ChatGPT?
Claude podlega tym samym regułom, a różnice leżą w szczegółach. Na kontach Free, Pro i Max o trenowaniu decyduje przełącznik „Help improve our AI models” w ustawieniach prywatności (Centrum prywatności Anthropic nazywa go „Model Improvement”). W planach Team i Enterprise Anthropic domyślnie nie trenuje modeli, a umowa powierzenia ze standardowymi klauzulami umownymi (SCC, czyli wzorem umowy zatwierdzonym przez Komisję Europejską do przekazywania danych poza Unię) obowiązuje od chwili akceptacji warunków komercyjnych. Anthropic podaje też wprost, że dane klientów przechowuje w USA. Szersze porównanie obu narzędzi znajdziesz w artykule Claude czy ChatGPT dla firmy.
A Gemini i Copilot?
Tu też liczy się rodzaj konta. W prywatnej aplikacji Gemini Google zaznacza, że część rozmów czytają recenzenci, a dane z takiego przeglądu przechowuje do trzech lat, i prosi, żeby nie wpisywać informacji poufnych. W Google Workspace Gemini nie trenuje modeli na danych klienta i nie przekazuje ich do przeglądu przez ludzi bez zgody, a dane podlegają umowie o przetwarzaniu danych Google Cloud. Microsoft Copilot Chat używany w organizacji jest objęty umową o ochronie danych Microsoftu, w której Microsoft działa jako podmiot przetwarzający, a zapytania i odpowiedzi nie służą do trenowania modeli bazowych.
Jakie dane pracownik może wkleić do ChatGPT?
Do konta prywatnego wolno wkleić tylko to, co mogłoby bez szkody trafić do internetu. Do planu firmowego z umową powierzenia wolno wkleić więcej, ale granice wyznacza polityka AI firmy, podstawa prawna i zasada minimalizacji.
Tabela pokazuje typowe rodzaje danych i to, co z nimi zrobić w każdym z dwóch przypadków. To punkt wyjścia do Waszej polityki, a ocenę konkretnej sprawy warto zostawić inspektorowi ochrony danych (IOD) albo prawnikowi.
| Rodzaj danych | Konto prywatne | Plan firmowy z umową powierzenia |
|---|---|---|
| Treści publiczne: artykuł z sieci, opis produktu ze strony, ogólne pytanie. | Wolno. | Wolno. |
| Własny szkic tekstu bez danych osób i bez informacji poufnych. | Wolno. | Wolno. |
| Mail od klienta z imieniem, nazwiskiem i numerem zamówienia. | Nie wolno. Najpierw zanonimizuj albo przejdź na konto firmowe. | Wolno, jeśli polityka na to pozwala, a przetwarzanie ma podstawę, na przykład wykonanie umowy z klientem. |
| Umowa z kontrahentem albo oferta z cenami. | Nie wolno, bo to zwykle tajemnica przedsiębiorstwa, a często także dane osób. | Wolno w zakresie, jaki dopuszcza polityka. Danych osób, które nie są potrzebne do zadania, lepiej usunąć. |
| CV kandydata, ocena pracownika, dane kadrowe. | Nie wolno. | Tylko po decyzji osoby odpowiedzialnej za dane albo IOD. Decyzję o kandydacie czy pracowniku podejmuje człowiek, bo art. 22 RODO ogranicza decyzje oparte wyłącznie na automatycznym przetwarzaniu. |
| Dane szczególnych kategorii: zdrowie, poglądy, dane biometryczne (art. 9 RODO). | Nie wolno. | Nie domyślnie. Wymagają szczególnej podstawy prawnej, a często także oceny skutków dla ochrony danych. |
| PESEL, numer dowodu, numer konta, dane karty płatniczej. | Nie wolno. | Nie domyślnie. Zadanie da się prawie zawsze wykonać bez tych numerów. |
| Hasła, klucze API, dane logowania. | Nigdy. | Nigdy. |
Z tabeli wynika prosta reguła dla zespołu: jeśli tekst zawiera coś, co pozwala rozpoznać konkretną osobę albo zaszkodzić firmie po wycieku, na koncie prywatnym nie ma dla niego miejsca. W planie firmowym hasła i numery identyfikacyjne dalej zostają poza czatem, a o reszcie decyduje polityka.
Twój zespół wie, czego nie wklejać do AI?
Na warsztacie Podstawy AI moduł „Bezpieczeństwo, dane i AI Act” omawia, czego nigdy nie wrzucać do AI, czym różnią się konta firmowe od darmowych i jakie obowiązki daje RODO. Uczestnicy wychodzą z listą kontrolną zgodności.
Jak zanonimizować dane przed wklejeniem do czatu AI?
Anonimizacja polega na takim przerobieniu tekstu, żeby nie dało się z niego rozpoznać żadnej osoby, ani bezpośrednio, ani przez połączenie z innymi informacjami. Dane naprawdę zanonimizowane przestają być danymi osobowymi i RODO ich nie obejmuje (motyw 26 RODO).
Trzeba przy tym odróżnić anonimizację od pseudonimizacji, czyli zastąpienia nazwiska kodem, który da się z powrotem przypisać do osoby. Europejska Rada Ochrony Danych (EROD, unijne grono wszystkich organów ochrony danych) w wytycznych 01/2025 potwierdza, że dane spseudonimizowane nadal są danymi osobowymi. Zamiana „Jan Kowalski” na „Klient 17” zmniejsza ryzyko, ale jeśli w firmie istnieje tabela, która mówi, kim jest Klient 17, z punktu widzenia prawa wciąż przetwarzasz dane osobowe.
Przed wklejeniem tekstu do czatu wystarczy przejść pięć kroków:
- Zamień imiona i nazwiska na role: „klient”, „kierownik budowy”, „kandydatka”.
- Usuń identyfikatory: PESEL, NIP osoby fizycznej, numery umów i zamówień, adresy, maile, telefony.
- Uogólnij szczegóły, które zdradzają osobę: dokładny wiek, małą miejscowość, jedyne takie stanowisko w firmie.
- Sprawdź kontekst, bo „prezes naszego największego klienta z Opola” rozpoznaje osobę bez nazwiska.
- Usuń metadane z plików, na przykład autora dokumentu i komentarze, albo wklejaj sam tekst zamiast pliku.
Przykład: zamiast „Pani Anna Nowak z Kórnika, umowa nr 2026/114, reklamuje drugą ratę” wklejasz „klientka reklamuje drugą ratę z umowy zawartej w tym roku”. Czat ułoży odpowiedź równie dobrze, bo do napisania uprzejmego maila nie potrzebuje nazwiska ani numeru umowy.
Pierwszy krok jutro rano: co zrobić bez budżetu?
Plan firmowy i umowa powierzenia to decyzje na kilka tygodni. Pięć rzeczy z tej listy zrobisz w jeden poranek, bez budżetu i bez prawnika. Nie zamkną tematu RODO, ale zatrzymają najprostszą drogę wycieku, czyli wklejanie danych klientów do prywatnych kont, i zostawią ślad, że firma sprawdziła narzędzie przed użyciem.
- 1Wyślij zespołowi jedną regułę o danych osobowych. Jedno zdanie łatwiej zapamiętać niż dokument na dwie strony. Skopiuj regułę z ramki pod listą i wpisz w nawias nazwę narzędzia firmowego. Jeśli firma takiego narzędzia jeszcze nie ma, skreśl tę część zdania i dopisz, do kiedy zapadnie decyzja.
- 2Pokaż ludziom, gdzie na prywatnym koncie wyłączyć trenowanie. W ChatGPT klikasz ikonę profilu, potem Settings, Data controls i wyłączasz „Improve the model for everyone”. Bez logowania to samo ustawienie znajdziesz w Settings, a wybór zapamięta przeglądarka. W Claude wchodzisz w Settings, potem w Privacy i wyłączasz „Help improve our AI models” (zrzut niżej). Podaję angielskie nazwy, bo w polskiej wersji interfejsu mogą brzmieć inaczej. Dopisz prośbę, żeby w rozmowach z danymi firmy nie oceniać odpowiedzi kciukiem.
- 3Sprawdź umowę powierzenia w narzędziu, które już macie. W ChatGPT Business umowę powierzenia (Data Processing Addendum, DPA) zawiera się przez formularz OpenAI. W Claude Team i Enterprise jest częścią warunków komercyjnych, więc wystarczy to zapisać. Copilot Chat na koncie służbowym Microsoft 365 obejmuje umowa o ochronie danych Microsoftu. Wynik wpisz do rejestru czynności przetwarzania.
- 4Wypełnij listę pytań UODO dla jednego zastosowania. Wybierz jedno zadanie, na przykład odpowiadanie na maile klientów w czacie, i przejdź dla niego listę dla małych i średnich firm, którą opisuję w sekcji o polityce. UODO każe ją wypełniać osobno dla każdego zastosowania, bo to samo narzędzie w obsłudze klienta i w rekrutacji niesie inne ryzyko.
- 5Wskaż osobę, której zgłasza się pomyłki. Jedno imię i jeden adres w tej samej wiadomości co reguła. Jeśli ktoś wklei dane klienta do prywatnego konta, firma ma 72 godziny na ocenę i ewentualne zgłoszenie do UODO, a liczą się one od chwili, w której się o tym dowie.
Danych osobowych klientów i pracowników (imion i nazwisk, maili, telefonów, adresów, numerów umów, PESEL-i) nie wklejamy do prywatnych kont ChatGPT, Claude, Gemini ani innych czatów AI, a jeśli zadanie ich wymaga, pracujemy w [narzędzie firmowe] albo najpierw zamieniamy nazwiska na role i usuwamy numery, adresy i maile.
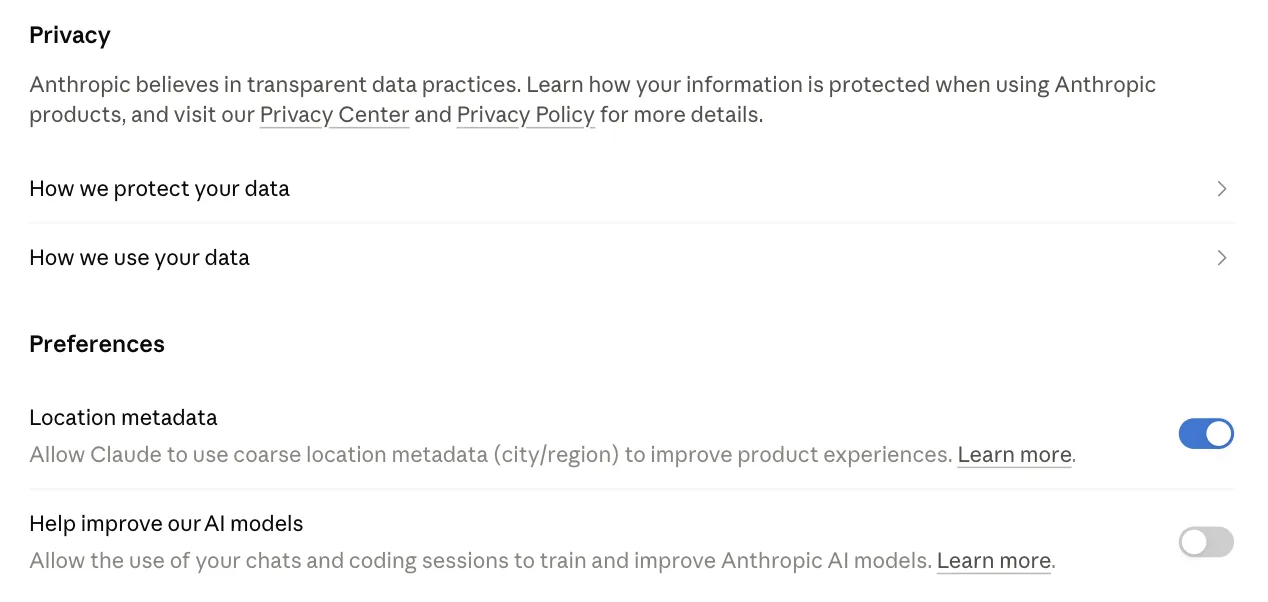
Drugi krok ma granice i dobrze je znać. OpenAI po wyłączeniu przestaje używać tylko nowych rozmów, więc to, co ktoś wkleił wcześniej, zostaje na starych zasadach. Przede wszystkim jednak wyłączony przełącznik nie daje firmie umowy powierzenia, dlatego reguła z pierwszego kroku obowiązuje także na koncie z wyłączonym trenowaniem.
Czy dane z ChatGPT mogą trafić do USA?
Mogą i jest to legalne, jeśli przekazanie ma podstawę z rozdziału V RODO (art. 44–49). Dla USA w praktyce liczą się dwie takie podstawy: decyzja Komisji Europejskiej o adekwatności dla firm z certyfikacją Data Privacy Framework (DPF, unijno-amerykańskich ram ochrony danych) oraz standardowe klauzule umowne.
Decyzję o DPF (2023/1795) zaskarżono. Sąd Unii Europejskiej oddalił skargę 3 września 2025 roku, ale skarżący odwołał się do Trybunału Sprawiedliwości (sprawa C-703/25 P), więc ostatnie słowo jeszcze nie padło. Dlatego w ocenie dostawcy warto sprawdzić, na jakiej podstawie przekazuje dane, i zapisać to w dokumentacji. Firmy, które muszą trzymać dane w Europie, mają dziś wybór: ChatGPT Enterprise z przechowywaniem danych w Europie albo Microsoft Copilot w ramach EU Data Boundary, czyli zobowiązania Microsoftu do przechowywania i przetwarzania danych klientów w Unii. Microsoft wyłącza jednak z tej granicy modele Anthropic.
Ostrożniej trzeba podejść do narzędzi, które trzymają dane w krajach bez decyzji o adekwatności. UODO zalecił ostrożność przy DeepSeek, bo według polityki prywatności dane użytkowników mogą trafiać na serwery w Chinach, a Komisja nie wydała dla Chin decyzji o adekwatności. Takiego narzędzia nie warto wpisywać na listę zatwierdzonych bez analizy prawnika.
Co zapisać w polityce AI, żeby uporządkować wklejanie danych?
Polityka AI powinna rozstrzygać, w jakich narzędziach wolno pracować, jakie dane wolno do nich wprowadzać i co zrobić po pomyłce. Pełny wzór z omówieniem znajdziesz w artykule Polityka AI w firmie, a tutaj opisuję tylko zapisy dotyczące danych.
- Lista zatwierdzonych narzędzi z planem: zamiast samego „ChatGPT” wpiszcie „ChatGPT Business na kontach firmowych”.
- Zakaz danych służbowych na kontach prywatnych, z jasną informacją, gdzie pracować zamiast nich.
- Tabela danych w rodzaju tej powyżej, dopasowana do Waszej branży, z obowiązkiem anonimizacji tam, gdzie się da.
- Zasada ocen: w rozmowach z danymi klientów nie oceniamy odpowiedzi kciukiem, bo ocena może przekazać rozmowę do trenowania.
- Upoważnienie i obowiązek poufności: osoby przetwarzające dane robią to na polecenie administratora (art. 29 RODO), a polityka staje się częścią tego polecenia.
- Procedura po pomyłce: komu zgłosić wklejenie danych, bez kar za samo zgłoszenie, bo na ocenę i ewentualne zgłoszenie do UODO firma ma 72 godziny (art. 33 RODO).
Do tego dochodzą dwie czynności poza samą polityką: aktualizacja rejestru czynności przetwarzania (RCP, spisu tego, jakie dane firma przetwarza i w jakim celu, art. 30 RODO) oraz sprawdzenie, czy nowe zastosowanie AI nie wymaga oceny skutków dla ochrony danych (DPIA, art. 35). Dobrym narzędziem na start jest lista pytań UODO dla małych i średnich firm, które korzystają z gotowych narzędzi AI: ma 26 pytań, wypełnia się ją w około 30 minut, a więcej niż trzy odpowiedzi „nie” to według UODO sygnał, że przed dalszym korzystaniem trzeba skonsultować się ze specjalistą. Wypełnioną listę warto zachować jako dowód, że firma sprawdziła narzędzie przed wdrożeniem.
Jaka jest rola IOD przy ChatGPT w firmie?
Inspektor ochrony danych (IOD) doradza firmie w sprawach RODO i monitoruje przestrzeganie przepisów (art. 39). Jeśli firma go ma, powinna włączyć go w wybór narzędzia AI i w pisanie polityki od początku, bo art. 38 ust. 1 każe angażować IOD we wszystkie sprawy dotyczące ochrony danych, i to w odpowiednim czasie.
Nie każda firma musi mieć IOD. Obowiązek z art. 37 dotyczy podmiotów publicznych i firm, których główna działalność polega na regularnym monitorowaniu osób na dużą skalę albo na przetwarzaniu na dużą skalę danych szczególnych kategorii. Firma bez IOD powinna wskazać jedną osobę, która rozstrzyga sporne przypadki i przyjmuje zgłoszenia pomyłek. Jeśli zastosowanie AI wymaga DPIA, a firma ma IOD, administrator musi zasięgnąć jego opinii (art. 35 ust. 2).
Co do tego wszystkiego ma AI Act?
AI Act, czyli unijne rozporządzenie 2024/1689 o sztucznej inteligencji, obowiązuje obok RODO. Dla firmy, która dała pracownikom ChatGPT, najważniejszy jest art. 4 o kompetencjach w zakresie AI, obowiązujący od 2 lutego 2025 roku.
Od 27 lipca 2026 roku art. 4 ma nowe brzmienie, nadane rozporządzeniem (UE) 2026/1744. Firmy podejmują środki, które wspierają rozwój kompetencji w zakresie AI wśród personelu, a przepis wprost zastrzega, że nie muszą gwarantować konkretnego poziomu u każdej osoby. Szkolenie z tego, co wolno wklejać do czatu, jest jednym z takich środków i dobrze go udokumentować. Więcej o obowiązkach piszemy na stronie AI Act dla firm.
Kto odpowiada, gdy pracownik wklei dane klienta?
Wobec Prezesa UODO odpowiada firma, bo to ona jest administratorem. Kary administracyjne za naruszenie podstawowych zasad przetwarzania sięgają 20 mln euro albo 4% całkowitego rocznego światowego obrotu, zależnie od tego, która kwota jest wyższa (art. 83 ust. 5 RODO). To górna granica, a urząd bierze pod uwagę między innymi charakter naruszenia i środki, które firma wcześniej wdrożyła.
Pracownik odpowiada wobec pracodawcy. Art. 100 § 2 pkt 4 kodeksu pracy nakazuje mu zachować w tajemnicy informacje, których ujawnienie mogłoby narazić pracodawcę na szkodę. Trudno jednak rozliczać kogoś z zasad, których nikt mu nie przekazał, dlatego polityka i szkolenie chronią obie strony.
Dostawca, który używa wklejonych danych do własnych celów, na przykład do trenowania modeli, w tym zakresie przestaje działać na polecenie firmy i sam staje się administratorem (art. 28 ust. 10 RODO). UODO zwraca na to uwagę w swojej liście pytań, dlatego ustawienie trenowania trzeba sprawdzić przed wdrożeniem.
Co to znaczy dla Twojej firmy?
Jeśli ludzie w Waszej firmie korzystają z czatów AI, a firma nie dała im narzędzia ani zasad, dane klientów mogą już trafiać do prywatnych kont. To zjawisko nazywa się shadow AI (korzystanie z narzędzi AI bez wiedzy i zgody firmy) i opisujemy je w artykule Shadow AI: co to jest. Tabela podpowiada pierwszy ruch w zależności od tego, gdzie jesteście dziś.
| Sytuacja w firmie | Pierwszy ruch w tym tygodniu |
|---|---|
| Pracownicy używają prywatnych kont, firma nie ma planu firmowego. | Wybierzcie plan firmowy z umową powierzenia i ogłoście, że dane klientów trafiają tylko tam. |
| Macie plan firmowy, ale nie podpisaliście umowy powierzenia. | W ChatGPT Business złóżcie u OpenAI formularz umowy powierzenia (Data Processing Addendum, DPA), a w innych narzędziach sprawdźcie, czy umowa jest częścią warunków. |
| Macie narzędzie i umowę, ale nie macie zasad. | Spiszcie tabelę danych i procedurę po pomyłce, a potem wypełnijcie listę pytań UODO dla małych i średnich firm. |
| Macie wszystko na papierze, ale ludzie nie wiedzą, co wolno. | Przeszkolcie zespół na jego realnych zadaniach, czyli na mailach i dokumentach, które dziś wkleja do czatu. |
W każdej z tych sytuacji pierwszy krok zajmuje kilka dni. Całość domyka szkolenie zespołu, które jest też środkiem wspierającym kompetencje z art. 4 AI Act.
Chcesz ułożyć zasady pracy z AI razem z zespołem?
Prowadzę warsztaty AI dla firm: 1 lub 2 dni, u Was w biurze albo online, w grupie do 15 osób. Przed szkoleniem robię audyt procesów, w pakiecie jest lista kontrolna zgodności z AI Act, a po warsztacie follow-up, czyli sprawdzenie, co weszło w życie.
Najczęstsze pytania
RODO ocenia sposób przetwarzania danych, więc zgodność zależy od tego, jak firma korzysta z ChatGPT. ChatGPT na planie Business albo Enterprise daje firmie umowę powierzenia przetwarzania danych i domyślnie nie trenuje modeli na jej treściach, więc da się z niego korzystać zgodnie z RODO. Prywatne konto pracownika takiej umowy nie daje, dlatego nie nadaje się do danych osobowych klientów ani pracowników.
Do prywatnego konta nie, bo firma nie ma wtedy umowy z dostawcą i nie kontroluje, co dzieje się z danymi. Do planu firmowego tak, jeśli firma ma umowę powierzenia, podstawę prawną z art. 6 RODO i zasady, które mówią, jakie dane wolno wprowadzać. Danych szczególnych kategorii, na przykład o zdrowiu, lepiej nie wklejać bez wcześniejszej konsultacji z inspektorem ochrony danych albo prawnikiem.
Nie wystarczy. Wyłączenie opcji „Improve the model for everyone” sprawia, że nowe rozmowy nie trafiają do treningu, ale firma nadal nie ma umowy powierzenia z OpenAI. Do tego ocena odpowiedzi kciukiem w górę albo w dół może sprawić, że cała rozmowa trafi do treningu mimo wyłączenia.
Na tych samych zasadach co ChatGPT. W planach Team i Enterprise Anthropic domyślnie nie trenuje modeli na danych firmy, a umowa powierzenia ze standardowymi klauzulami umownymi UE jest automatycznie częścią warunków komercyjnych. Anthropic informuje, że dane klientów przechowuje w USA, co trzeba uwzględnić w ocenie przekazywania danych poza EOG.
Nie. Inspektora ochrony danych muszą wyznaczyć podmioty publiczne oraz firmy, których główna działalność polega na monitorowaniu osób na dużą skalę albo na przetwarzaniu na dużą skalę danych szczególnych kategorii (art. 37 RODO). Jeśli firma ma IOD, powinna włączyć go w wybór narzędzia AI i w pisanie polityki od początku.
Wobec Prezesa UODO odpowiada firma jako administrator danych. Może to być naruszenie ochrony danych, które trzeba ocenić i w razie ryzyka zgłosić w ciągu 72 godzin (art. 33 RODO), a kary administracyjne za naruszenie zasad przetwarzania sięgają 20 mln euro albo 4% rocznego światowego obrotu. Pracownik może ponieść odpowiedzialność pracowniczą, bo kodeks pracy nakazuje mu chronić informacje, których ujawnienie może narazić pracodawcę na szkodę.