Wyjaśnienia opieram na badaniu OpenAI i dokumentacji Anthropic, a przykłady na orzeczeniach i renomowanych mediach podlinkowanych w sekcji „Źródła”. Wyniki testów halucynacji zmieniają się z każdą nową wersją modelu. Stan na październik 2026.
W skrócie
- Halucynacja AI to wiarygodnie brzmiąca, ale fałszywa odpowiedź modelu: zmyślony fakt, źródło, cytat albo liczba.
- Modele halucynują, bo przewidują kolejne słowa, nie mają z czego nauczyć się faktów, które w danych treningowych pojawiły się raz, a testy, na których się je ocenia, nagradzają zgadywanie bardziej niż „nie wiem”.
- Nawet przy streszczaniu dostarczonego dokumentu popularne modele dodają nieprawdziwe informacje do 6,5–12 procent streszczeń: najlepsze z nich do co piętnastego, najsłabsze do co ósmego (tablica Vectara, 22 września 2026).
- Najskuteczniej ograniczają je: praca na dokumentach, zgoda na „nie wiem”, dosłowne cytaty, wyszukiwanie z linkami i sprawdzenie u źródła.
- Bez weryfikacji nie używaj AI do prawa, liczb, cytatów i informacji dla klientów. Tu zasada brzmi: AI szkicuje, człowiek zatwierdza.
- Najprostszy start to trzy nawyki, które wprowadzisz od jutra w każdym czacie, także darmowym: poproś o źródła i je otwórz, wklejaj własny tekst jako podstawę odpowiedzi i pytaj model, czego nie jest pewien. Polecenia do skopiowania.
Czym są halucynacje AI?
Halucynacje AI to odpowiedzi, w których model językowy podaje nieprawdę tonem pewnym siebie. Badacze OpenAI w artykule z września 2025 roku opisują je jako wiarygodnie brzmiące, ale błędne stwierdzenia, które model wypowiada zamiast przyznać się do niepewności. Pojęcie „halucynacje AI” jest umowne: model niczego nie widzi, po prostu produkuje tekst, który wygląda na prawdziwy.
W tym samym artykule badacze pokazują przykład. Zapytali model DeepSeek-V3 o datę urodzin jednego z autorów, Adama Taumana Kalaia, i dodali, żeby odpowiedział tylko wtedy, gdy wie. Model w trzech próbach podał trzy różne daty i każda była błędna.
W pracy biurowej halucynacje przybierają trzy główne formy. Pierwsza to zmyślony fakt: data, nazwisko, cena albo przepis. Druga to zmyślone źródło: tytuł raportu, którego nikt nie napisał, albo cytat, którego nikt nie wypowiedział. Trzecia jest najmniej oczywista: model dopisuje do streszczenia czy analizy coś, czego nie było w dokumencie, który sam mu przekazałeś.
Trzy nawyki, które ograniczą halucynacje od jutra
Nie potrzebujesz płatnego planu ani ustawień. Wystarczy darmowy czat: ChatGPT na chatgpt.com, Claude albo Gemini na darmowym koncie. 5 października 2026 r. sprawdziliśmy z Polski, że ChatGPT odpowiada nawet bez logowania. Pomoc OpenAI podaje jednak, że w Unii ta możliwość jeszcze nie działa, więc jeśli strona poprosi o zalogowanie, załóż darmowe konto. Do ćwiczeń nie wklejaj prawdziwych danych osobowych ani dokumentów firmy, bo darmowe konto to konto prywatne.
1. Poproś o źródła i otwórz je
Dopisz to zdanie pod pytaniem o fakty. Działa najlepiej, gdy czat ma włączone wyszukiwanie w sieci.
Do każdego faktu, liczby i daty w swojej odpowiedzi dopisz link do źródła, z którego go bierzesz. Jeśli źródła nie masz, napisz przy tym zdaniu „bez źródła”.
Sam link niczego nie dowodzi, bo model potrafi źle streścić prawdziwą stronę. Otwórz przynajmniej te źródła, na których opiera się Twoja decyzja, i sprawdź, czy mówią to samo co odpowiedź. Zdania oznaczone „bez źródła” traktuj jak hipotezę.
2. Wklejaj własny tekst jako podstawę
Model, który ma przed sobą tekst, zgaduje rzadziej niż model, który odpowiada z pamięci. Do ćwiczeń w darmowym czacie weź tekst publiczny, na przykład regulamin ze strony internetowej albo ogólnodostępny raport.
Odpowiedz wyłącznie na podstawie tekstu poniżej. Jeśli w tekście nie ma odpowiedzi, napisz „Nie ma tego w tekście” i niczego nie dopowiadaj.

[tu wklejasz tekst]

Pytanie: [Twoje pytanie]
Pełniejszą wersję tego polecenia, z numerowanymi cytatami, znajdziesz niżej w sekcji Jak ograniczyć halucynacje AI w pracy.
3. Pytaj, czego model nie jest pewien
Po odpowiedzi, z której chcesz skorzystać, wyślij jeszcze jedno polecenie.
Które twierdzenia z Twojej odpowiedzi mogą być błędne albo nieaktualne? Wypisz je i przy każdym napisz, gdzie mogę to sprawdzić.
Model myli się także w ocenie własnej pewności, więc ta lista nie jest dowodem, że reszta odpowiedzi jest prawdziwa. Pokazuje za to, od czego zacząć sprawdzanie, gdy masz na nie pięć minut, a nie godzinę.
Dlaczego modele AI halucynują?
Model językowy halucynuje, bo jest wytrenowany do przewidywania kolejnego tokenu, czyli fragmentu słowa, który najlepiej pasuje do poprzednich. Gdy pytasz o coś, czego dobrze nie zna, nadal tworzy najbardziej prawdopodobną odpowiedź. Badanie i wpis OpenAI z września 2025 roku wskazują trzy przyczyny, które się na siebie nakładają.
Fakty, które pojawiły się raz. Regularne wzory, takie jak pisownia czy gramatyka, model łapie z milionów przykładów. Data urodzin mało znanej osoby może jednak wystąpić w danych treningowych tylko raz i model nie ma z czego jej się nauczyć. Autorzy szacują, że jeśli na przykład 20 procent takich faktów pojawia się w danych jeden raz, model będzie halucynował przy około 20 procentach pytań o nie.
Testy nagradzają zgadywanie. Większość testów, na których porównuje się modele, przyznaje punkt za dobrą odpowiedź i zero za błędną albo za „nie wiem”. To jak egzamin bez punktów ujemnych: kto zgaduje, wypada lepiej niż ktoś, kto zostawia puste pole. Modele są trenowane, żeby dobrze wypadać w takich testach, więc uczą się zgadywać.
Pytania bez odpowiedzi. Część pytań jest po prostu nierozstrzygalna, bo brakuje danych. OpenAI pisze wprost, że trafność modeli nigdy nie osiągnie 100 procent, niezależnie od ich wielkości i możliwości wyszukiwania.
Jak mocno to działa, OpenAI pokazało na teście SimpleQA, czyli zestawie krótkich pytań o fakty. Tabela porównuje dwa modele tej firmy: nowszy, który częściej mówi „nie wiem”, i starszy, który prawie zawsze odpowiada.
| Model | Odmowa odpowiedzi („nie wiem”) | Dobre odpowiedzi | Błędne odpowiedzi |
|---|---|---|---|
| gpt-5-thinking-mini (nowszy) | 52% | 22% | 26% |
| o4-mini (starszy) | 1% | 24% | 75% |
Oba modele trafiają mniej więcej tak samo często, ale starszy myli się prawie trzy razy częściej, bo zgaduje, zamiast się wstrzymać. W rankingu, który liczy tylko trafienia, wypadłby lepiej. W pracy częstsze „nie wiem” jest zaletą modelu, bo każdą błędną odpowiedź ktoś musi potem wyłapać.
Jak często AI halucynuje?
Zależy od zadania. Nawet wtedy, gdy model dostaje gotowy dokument, myli się regularnie. Firma Vectara prowadzi publiczną tablicę wyników, w której modele streszczają ponad 7700 dokumentów z poleceniem, żeby korzystały wyłącznie z ich treści. Każde streszczenie sprawdza model HHEM, czyli narzędzie Vectary oceniające, czy tekst zgadza się ze źródłem.
W aktualizacji z 22 września 2026 roku odsetek streszczeń z halucynacją wynosił od 1,8 do 24,2 procent. Z popularnych modeli najlepiej wypadły najnowsze modele OpenAI: GPT-6 Sol miał 6,5 procent, a GPT-6 Astra 8,7 procent. GPT-5.5 miał 9,3 procent, Gemini 3.1 Pro w wersji testowej 10,4 procent, Claude Sonnet 4.6 10,6 procent, a Claude Opus 4.7 12 procent. Oznacza to, że popularne modele dopisują coś spoza dokumentu do mniej więcej co piętnastego streszczenia w najlepszym razie i do co ósmego w najgorszym, choć dostały tekst źródłowy i jasne polecenie.
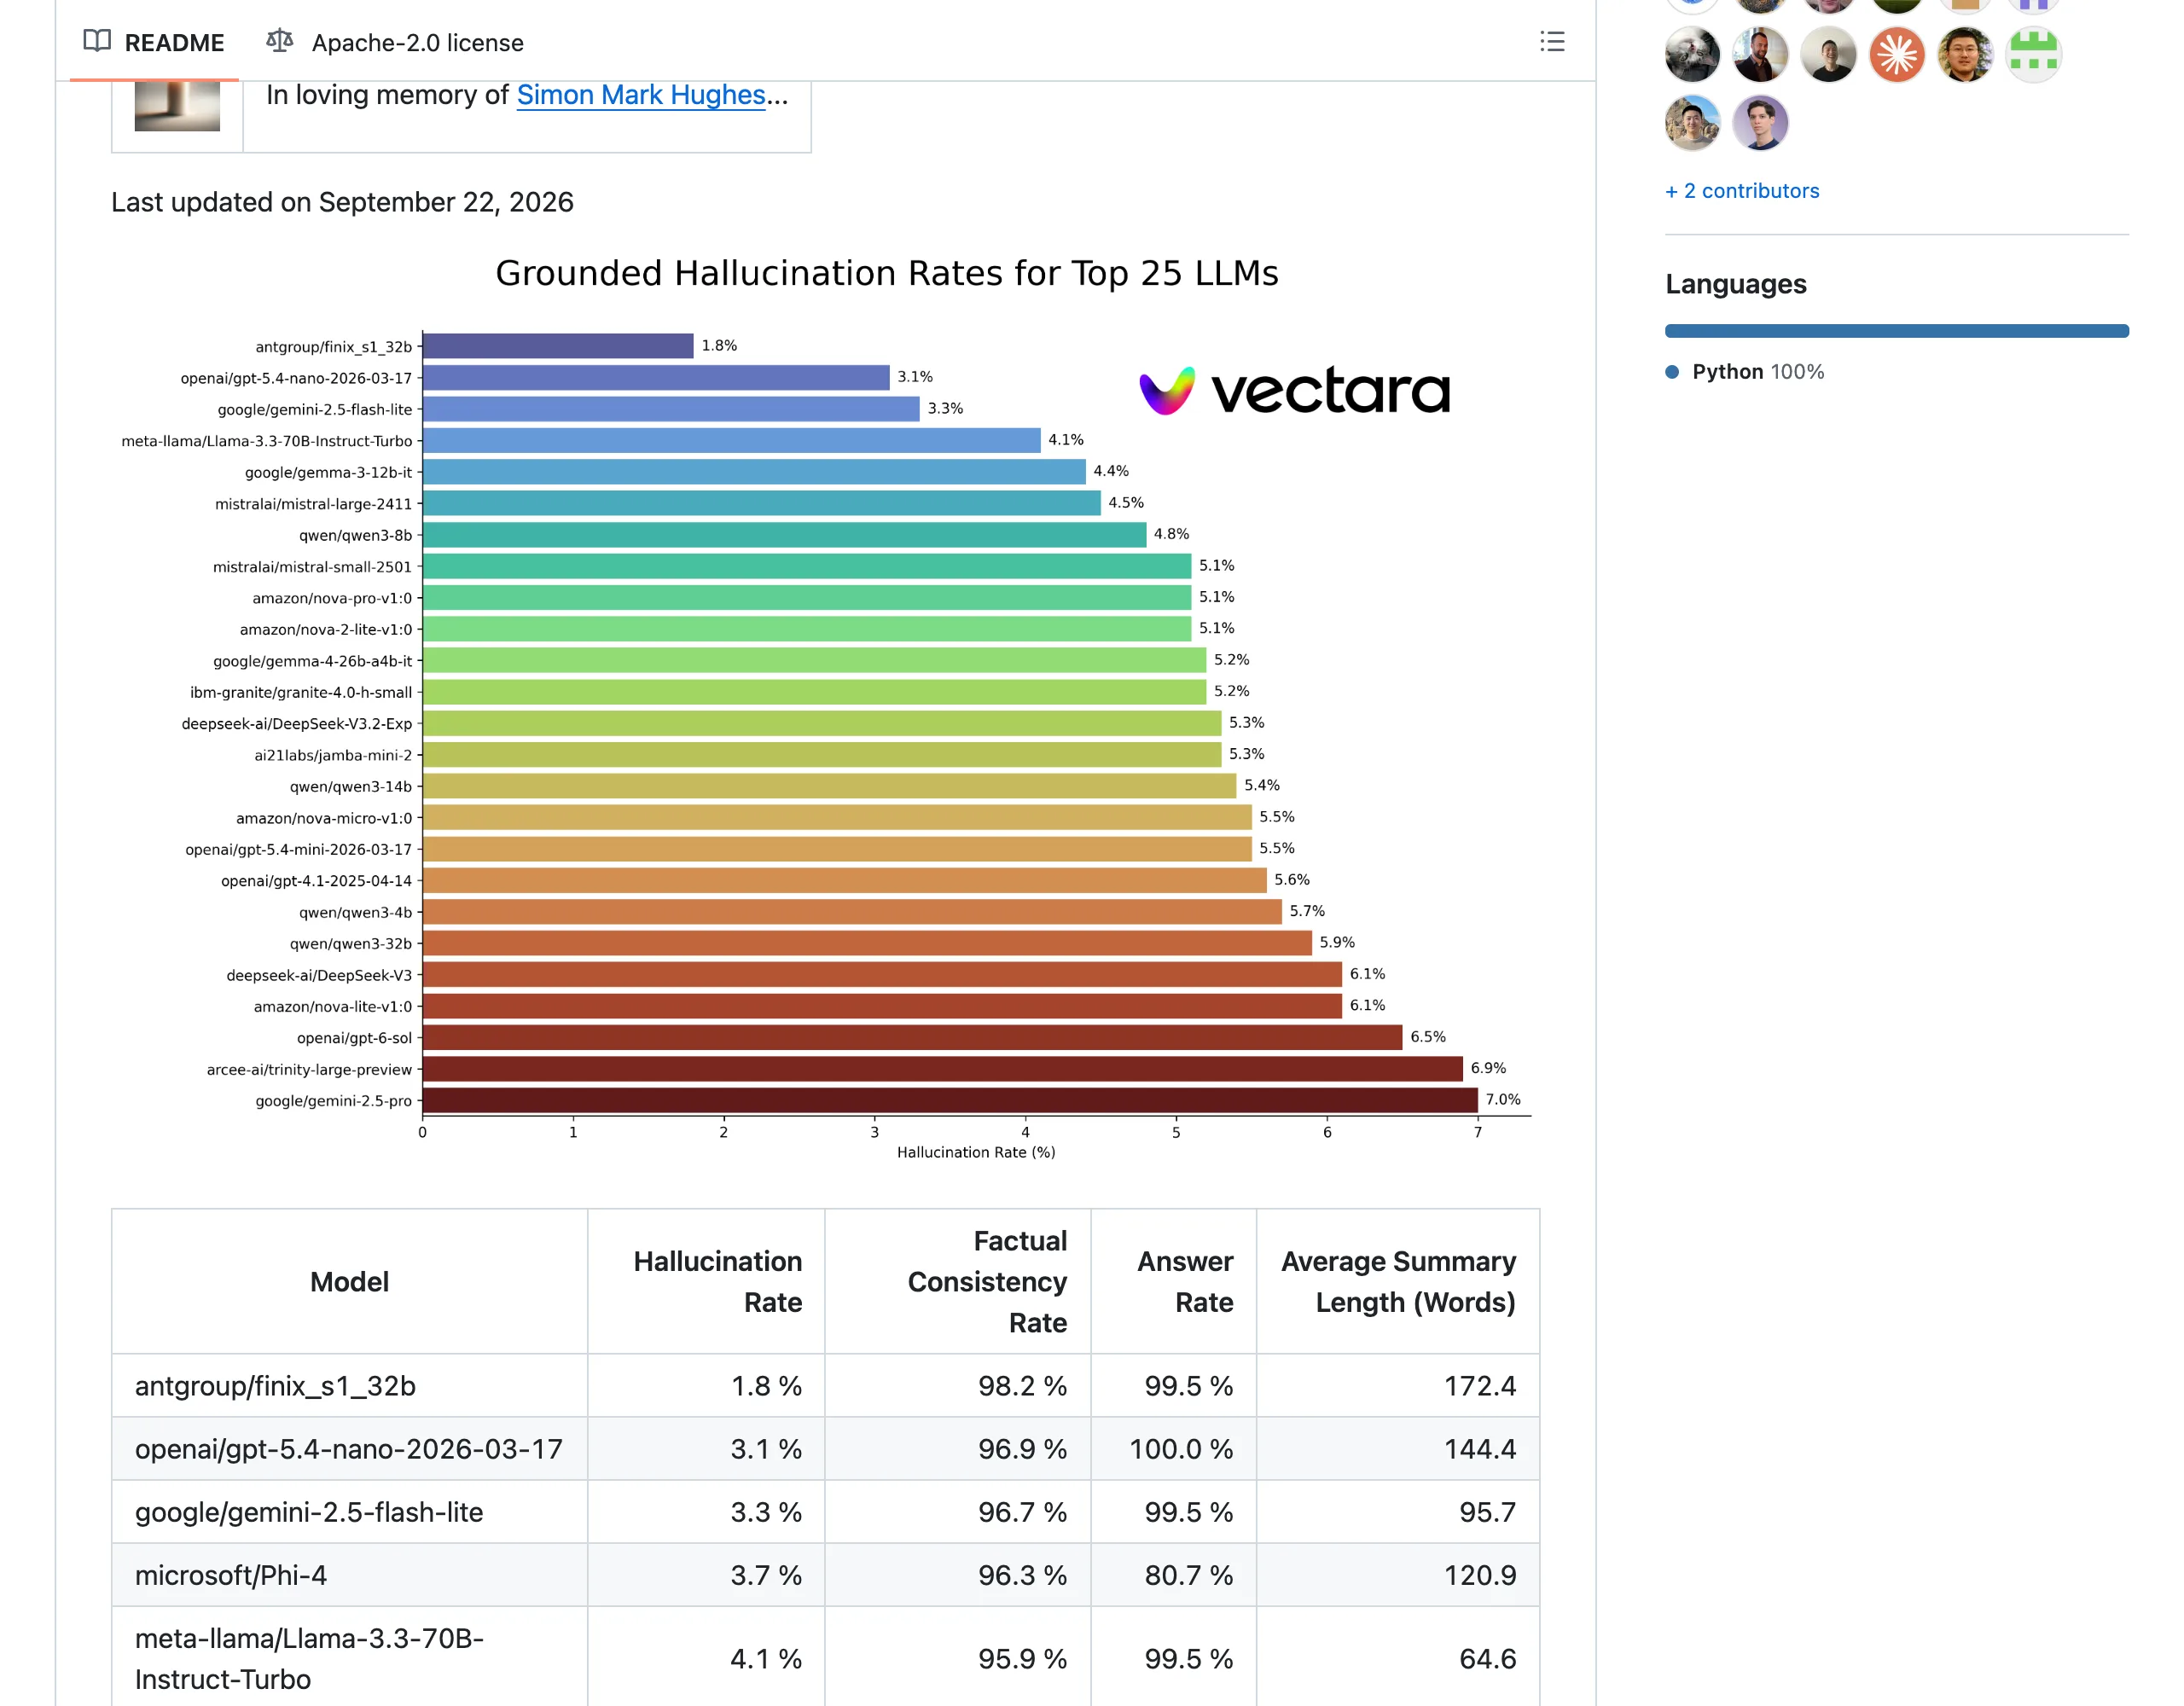
Ten wynik trzeba czytać ostrożnie. Tablica mierzy jedno zadanie, nie zawsze obejmuje najnowsze wersje modeli (we wrześniowej aktualizacji nie ma na przykład modeli Claude z rodziny Opus 5), a oceniającym jest model samej Vectary. Wklejony dokument zmniejsza więc ryzyko, ale go nie usuwa.
Halucynacje AI — przykłady z prawdziwymi konsekwencjami
Poniższe trzy sprawy są opisane w orzeczeniach albo w renomowanych mediach. Każda pokazuje inną sytuację: pismo procesowe, chatbota na stronie i raport dla klienta.
Mata v. Avianca: wymyślone orzeczenia w sądzie (2023)
Prawnicy pasażera, który pozwał linię Avianca, złożyli w sądzie federalnym w Nowym Jorku pismo z orzeczeniami, które wygenerował ChatGPT i które nie istniały. Jeden z nich, gdy pojawiły się wątpliwości, zapytał ChatGPT, czy sprawa „Varghese” jest prawdziwa. Model odpowiedział, że tak i że można ją znaleźć w bazach Westlaw i LexisNexis.
22 czerwca 2023 roku sędzia P. Kevin Castel nałożył na dwóch prawników i ich kancelarię 5000 dolarów kary. W uzasadnieniu napisał, że korzystanie z wiarygodnego narzędzia AI nie jest samo w sobie niewłaściwe, ale to prawnik ma obowiązek pilnować prawdziwości tego, co składa w sądzie. Od tamtej pory takich spraw przybywa: baza prowadzona przez Damiena Charlotina zawiera 2125 orzeczeń, w których sądy zajmowały się halucynacjami AI (stan na 2 października 2026).
Moffatt v. Air Canada: chatbot obiecał zwrot, którego nie było (2024)
Po śmierci babci Jake Moffatt zapytał chatbota na stronie Air Canada o tańsze bilety w związku ze śmiercią bliskiej osoby. Chatbot odpowiedział, że o zniżkę może wnioskować po podróży. Zasady linii, opisane na innej podstronie, na to nie pozwalały. Air Canada argumentowała przed trybunałem w Kolumbii Brytyjskiej, że chatbot jest odrębnym podmiotem i sam odpowiada za swoje słowa.
Trybunał nazwał to stanowisko zaskakującym i uznał, że firma odpowiada za wszystkie informacje na swojej stronie, niezależnie od tego, czy podaje je statyczna podstrona, czy chatbot. 14 lutego 2024 roku nakazał linii zapłacić łącznie 812,02 dolara kanadyjskiego, z czego 650,88 to odszkodowanie. Orzeczenie nie opisuje, na jakiej technologii działał chatbot, ale mechanizm jest ten sam: automat podał klientowi nieprawdę, a koszt poniosła firma.
Deloitte i raport dla rządu Australii: zmyślone przypisy (2025)
Deloitte przygotował dla australijskiego ministerstwa zatrudnienia (DEWR) raport o systemie, który automatycznie nakłada kary na bezrobotnych pobierających świadczenia. Kontrakt był wart około 440 tys. dolarów australijskich. Po publikacji w lipcu 2025 roku dr Christopher Rudge z Uniwersytetu w Sydney wskazał w raporcie odwołania do nieistniejących publikacji i zmyślony cytat z wyroku sądu federalnego.
W poprawionej wersji Deloitte ujawnił, że część raportu powstała z użyciem modelu GPT-4o w usłudze Azure OpenAI. Ministerstwo podało, że zalecenia raportu się nie zmieniły, a firma zwróciła 97 tys. dolarów australijskich, czyli niecałą jedną czwartą wartości kontraktu.
We wszystkich trzech sprawach powtarza się ten sam schemat: wynik AI wyszedł na zewnątrz, zanim ktoś sprawdził go u źródła. Za każdym razem koszt ponieśli ludzie i firmy, które tego wyniku użyły.
Chcesz, żeby zespół wiedział, kiedy AI zmyśla?
Na warsztacie Podstawy AI tłumaczę, dlaczego model językowy halucynuje, i ćwiczymy weryfikację wyników na Waszych dokumentach. 1 lub 2 dni, stacjonarnie albo online, w grupie do 15 osób.
Jak ograniczyć halucynacje AI w pracy?
Halucynacji nie da się wyłączyć, ale da się sprawić, że będzie ich mniej, a te, które zostaną, łatwiej wyłapiesz. Pierwsze cztery sposoby pochodzą z dokumentacji Anthropic „Reduce hallucinations”. To zwykłe polecenia, więc możesz je stosować także w ChatGPT i Gemini. Trzy kolejne dotyczą narzędzi i organizacji pracy.
- Daj modelowi dokumenty i każ pracować tylko na nich. Wklej umowę, raport albo notatkę i napisz wprost, żeby nie korzystał z własnej wiedzy. Model, który ma źródło, zgaduje rzadziej niż model, który odpowiada z pamięci.
- Pozwól mu powiedzieć „nie wiem”. Dopisz: „Jeśli w materiale nie ma odpowiedzi, napisz, że jej nie ma”. Anthropic podaje, że ta prosta zgoda potrafi wyraźnie zmniejszyć liczbę fałszywych informacji, co pasuje do wniosków OpenAI o nagradzaniu zgadywania.
- Poproś o dosłowne cytaty przed odpowiedzią. Przy długich dokumentach każ modelowi najpierw wypisać fragmenty, na których się opiera, a dopiero potem odpowiadać. Możesz też kazać mu po napisaniu tekstu znaleźć cytat dla każdego twierdzenia i usunąć twierdzenia, dla których cytatu nie ma.
- Zadaj to samo pytanie kilka razy. Anthropic nazywa to weryfikacją best-of-N, czyli porównaniem kilku odpowiedzi na ten sam prompt. Jeśli w nowym czacie model podaje inną datę albo inną kwotę, masz sygnał, że zgaduje.
- Przy faktach z zewnątrz włącz wyszukiwanie w sieci. Pytania o aktualne ceny, przepisy czy dane firm zadawaj z włączonym wyszukiwaniem, żeby model podał linki. Potem otwórz przynajmniej te, na których opiera się decyzja.
- Sprawdzaj u źródła to, co najczęściej bywa zmyślone. Nazwiska, liczby, daty, tytuły publikacji, cytaty i numery przepisów weryfikuj w oryginale: w ISAP, EUR-Lex, raporcie, umowie albo na stronie producenta.
- Stosuj zasadę „AI szkicuje, człowiek zatwierdza”. Każdy tekst, który wychodzi do klienta, sądu, urzędu albo zarządu, ma nazwaną osobę, która go sprawdziła i za niego odpowiada.
Pierwsze trzy sposoby łatwo połączyć w jeden prompt. Poniższy wzór jest przykładem złożonym z technik z dokumentacji Anthropic. Wystarczy go skopiować i wkleić własny materiał.
<dokumenty>
[tu wklejasz umowę, raport albo notatki ze spotkania]
</dokumenty>

Odpowiedz na pytanie wyłącznie na podstawie dokumentów powyżej. Nie korzystaj z własnej wiedzy.
1. Najpierw wypisz dosłowne cytaty, na których się opierasz, i ponumeruj je.
2. Potem odpowiedz, powołując się na numery cytatów.
3. Jeśli w dokumentach nie ma odpowiedzi, napisz „Nie ma tego w dokumentach” i niczego nie dopowiadaj.

Pytanie: [Twoje pytanie]
Dzięki numerowanym cytatom każde zdanie odpowiedzi sprawdzisz w kilka sekund, a model ma gotową formułkę na sytuację, w której odpowiedzi nie ma. Więcej technik pisania poleceń znajdziesz w artykule Prompt engineering: co to jest i jak pisać prompty w pracy.
Gdzie nie używać AI bez weryfikacji?
Ryzyko halucynacji zależy od dwóch rzeczy: czy model ma źródło i ile kosztuje błąd. Tabela układa typowe zadania biurowe od najbezpieczniejszych do tych, w których wynik AI zawsze wymaga sprawdzenia przez człowieka.
| Typ zadania | Ryzyko halucynacji | Co zrobić |
|---|---|---|
| Burza mózgów, pomysły na tytuły i nazwy | Niskie, bo błędny pomysł nic nie kosztuje. | Używaj swobodnie i wybierz najlepsze propozycje. |
| Redakcja i skracanie własnego tekstu | Niskie do średniego, bo model potrafi dopisać fakt, którego nie było. | Porównaj wynik z oryginałem, zwłaszcza liczby i nazwiska. |
| Streszczenie dostarczonego dokumentu | Średnie: w teście Vectara popularne modele mylą się w co piętnastym do co ósmego streszczenia. | Poproś o cytaty i sprawdź liczby w dokumencie. |
| Pytania o fakty bez źródła (daty, osoby, firmy) | Wysokie, bo model odpowiada z pamięci i zgaduje przy rzadkich faktach. | Włącz wyszukiwanie z linkami i sprawdź fakt u źródła. |
| Liczby, obliczenia i dane finansowe | Wysokie, bo model przewiduje kolejne fragmenty tekstu i może podać wynik, który tylko wygląda na policzony. | Licz w arkuszu albo każ modelowi pokazać obliczenia i sprawdź ręcznie przynajmniej dwie pozycje. |
| Przepisy, orzeczenia i umowy | Bardzo wysokie: w bazie Damiena Charlotina jest już ponad 2100 orzeczeń dotyczących halucynacji AI. | Pracuj na tekście przepisu z ISAP albo EUR-Lex, a ważne wnioski daj do oceny prawnikowi. |
| Cytaty i przypisy w raporcie dla klienta | Bardzo wysokie, co pokazał raport Deloitte. | Otwórz każde źródło i porównaj cytat z oryginałem. |
| Odpowiedzi chatbota dla klientów | Bardzo wysokie, bo za obietnicę chatbota odpowiada firma, jak w sprawie Air Canada. | Ogranicz chatbota do zatwierdzonej bazy wiedzy, przetestuj go przed wdrożeniem i daj klientowi drogę do człowieka. |
Im niżej w tabeli, tym ważniejsze, żeby było wiadomo, kto wynik sprawdził. Przy zadaniach z ryzykiem bardzo wysokim wpiszcie weryfikację w proces jako obowiązkowy krok przed wysłaniem.
Co to znaczy dla Twojej firmy?
Halucynacje są stałą cechą modeli językowych i według OpenAI nie znikną w kolejnych wersjach, więc pracę trzeba ułożyć tak, żeby je wyłapywać. Firma, która daje ludziom dostęp do ChatGPT, Claude czy Gemini bez zasad weryfikacji, zostawia pojedynczym pracownikom decyzję, co sprawdzić, a skutki błędu i tak ponosi sama, jak Air Canada. Tabela podpowiada pierwszy ruch zależnie od tego, gdzie jesteście dziś.
| Sytuacja w firmie | Co zrobić w tym miesiącu |
|---|---|
| Pracownicy korzystają z AI, ale nikt nie ustalił, co trzeba sprawdzać. | Spiszcie zadania z ryzykiem bardzo wysokim z tabeli powyżej i wpiszcie do polityki AI zasadę „AI szkicuje, człowiek zatwierdza” z nazwanym właścicielem wyniku. |
| Zespół wkleja dokumenty, ale ufa streszczeniom bez sprawdzania. | Wprowadźcie wspólny prompt z cytatami i zgodą na „nie wiem” i zapiszcie go jako instrukcję projektu w narzędziu, którego używacie. |
| Planujecie chatbota dla klientów. | Zanim go uruchomicie, ustalcie, z jakiej bazy wiedzy korzysta, kto testuje jego odpowiedzi i kiedy przekazuje rozmowę człowiekowi. |
Jak spisać takie zasady, pokazuję w artykule Polityka AI w firmie: co musi zawierać. Jeśli dopiero wybieracie narzędzie, porównanie planów znajdziesz w tekście Claude czy ChatGPT: który model wybrać dla firmy. Zasady działają, gdy cały zespół rozumie, skąd biorą się halucynacje, i ma te same nawyki weryfikacji. Na warsztacie Podstawy AI uczymy tego na zadaniach Waszego zespołu, a przed szkoleniem robię audyt procesów, żeby ćwiczenia dotyczyły dokumentów, na których ludzie naprawdę pracują.
Naucz zespół pracować z AI tak, żeby zmyślenia nie wychodziły na zewnątrz
Prowadzę warsztaty AI dla firm: 1 lub 2 dni, u Was w biurze albo online, w grupie do 15 osób. Przed szkoleniem robię audyt procesów, a po warsztacie follow-up, czyli sprawdzenie, co weszło w codzienną pracę.
Najczęstsze pytania
Halucynacja AI to odpowiedź modelu językowego, która brzmi wiarygodnie, ale jest nieprawdziwa: zmyślony fakt, nieistniejące źródło, wymyślony cytat albo informacja, której nie ma w dokumencie przekazanym modelowi. Model przewiduje najbardziej prawdopodobny ciąg słów, a gdy brakuje mu wiedzy, często zgaduje zamiast przyznać, że nie wie.
Najgłośniejsze to sprawa Mata v. Avianca z 2023 roku, w której prawnicy złożyli w sądzie w Nowym Jorku pismo z orzeczeniami wymyślonymi przez ChatGPT i dostali 5000 dolarów kary. Druga to Moffatt v. Air Canada z 2024 roku: chatbot linii podał klientowi błędną zasadę zwrotu, a trybunał kazał firmie zapłacić. Trzecia to raport Deloitte dla australijskiego ministerstwa z 2025 roku, w którym znalazły się nieistniejące publikacje i zmyślony cytat z wyroku; firma zwróciła część wynagrodzenia.
Nie. OpenAI we wpisie z września 2025 roku pisze, że trafność modeli nigdy nie osiągnie 100 procent, bo na część pytań nie da się odpowiedzieć. Anthropic w dokumentacji zaznacza, że techniki ograniczania halucynacji zmniejszają ich liczbę, ale ich nie usuwają. Dlatego w firmie potrzebna jest weryfikacja przez człowieka przy każdym ważnym wyniku.
Nie ma jednej odpowiedzi, bo wynik zależy od zadania i od wersji modelu. W tablicy Vectara, która mierzy halucynacje przy streszczaniu dokumentów, w aktualizacji z 22 września 2026 roku wyniki wahały się od 1,8 do 24,2 procent streszczeń z błędem, a popularne modele GPT, Claude i Gemini miały od 6,5 do 12 procent. Przed wyborem warto sprawdzić model na własnych dokumentach.
Zmniejsza ryzyko przy pytaniach o fakty, bo model opiera odpowiedź na znalezionych stronach i podaje do nich linki. Nie daje jednak gwarancji: model może źle streścić źródło albo oprzeć się na słabej stronie. Linki służą do tego, żeby je otworzyć i sprawdzić, czy mówią to, co twierdzi model.
W znanych sprawach odpowiadali ludzie i firmy, które z narzędzia korzystały. Sąd w sprawie Mata v. Avianca uznał, że to prawnik ma obowiązek sprawdzić prawdziwość swojego pisma. Trybunał w sprawie Moffatt v. Air Canada odrzucił argument, że chatbot odpowiada sam za siebie, i uznał, że firma odpowiada za wszystkie informacje na swojej stronie. To materiał edukacyjny, nie porada prawna.